Przejdź do treści
Visiticsby esentra
PL

Za darmo w Nova i w każdym planie

AI Observability: ile kosztuje twoje AI i jak działa

Twoja aplikacja wywołuje OpenAI, Anthropic, Google, Mistral albo własny model. Visitics pokazuje, ile kosztuje każde wywołanie, jak jest szybkie i jak często zawodzi, według modelu, funkcji i wersji promptu. Zachowuje tylko liczby i nazwy: promptów i odpowiedzi nigdy nie zapisuje.

Do czego to służy

W czym ci pomoże

  1. 01

    Koszty, które umiesz wyjaśnić

    Zamiast jednej sumy na fakturze dostawcy widzisz koszt według modelu, funkcji, wersji promptu i użytkownika, z miesięcznym budżetem i prognozą na cały miesiąc.

  2. 02

    Szybkość i błędy w jednym miejscu

    Opóźnienie p50 i p95, czas do pierwszego tokena i błędy każdego modelu, a każde żądanie jako kaskada jego kroków.

  3. 03

    Liczby, nigdy treść

    Prompty i odpowiedzi są odrzucane, zanim cokolwiek zostanie zapisane, i żadne ustawienie tego nie zmienia. Visitics nie przechowuje rozmów twoich użytkowników.

Jak to działa

Prawdziwe ekrany panelu

I.

Przegląd twojego AI

Sześć liczb ze zmianą względem poprzedniego okresu, to, na co spojrzeć najpierw, i koszt każdego dnia według modelu. Całą stronę przefiltrujesz według środowiska, dostawcy, modelu lub funkcji.

  1. 1Wywołania, koszt, tokeny, opóźnienie, pierwszy token i błędy
  2. 2Na co spojrzeć, z liczbą, która za tym stoi
  3. 3Koszt według modelu, dzień po dniu
  4. 4Dotychczasowy miesiąc, jego prognoza i twój budżet
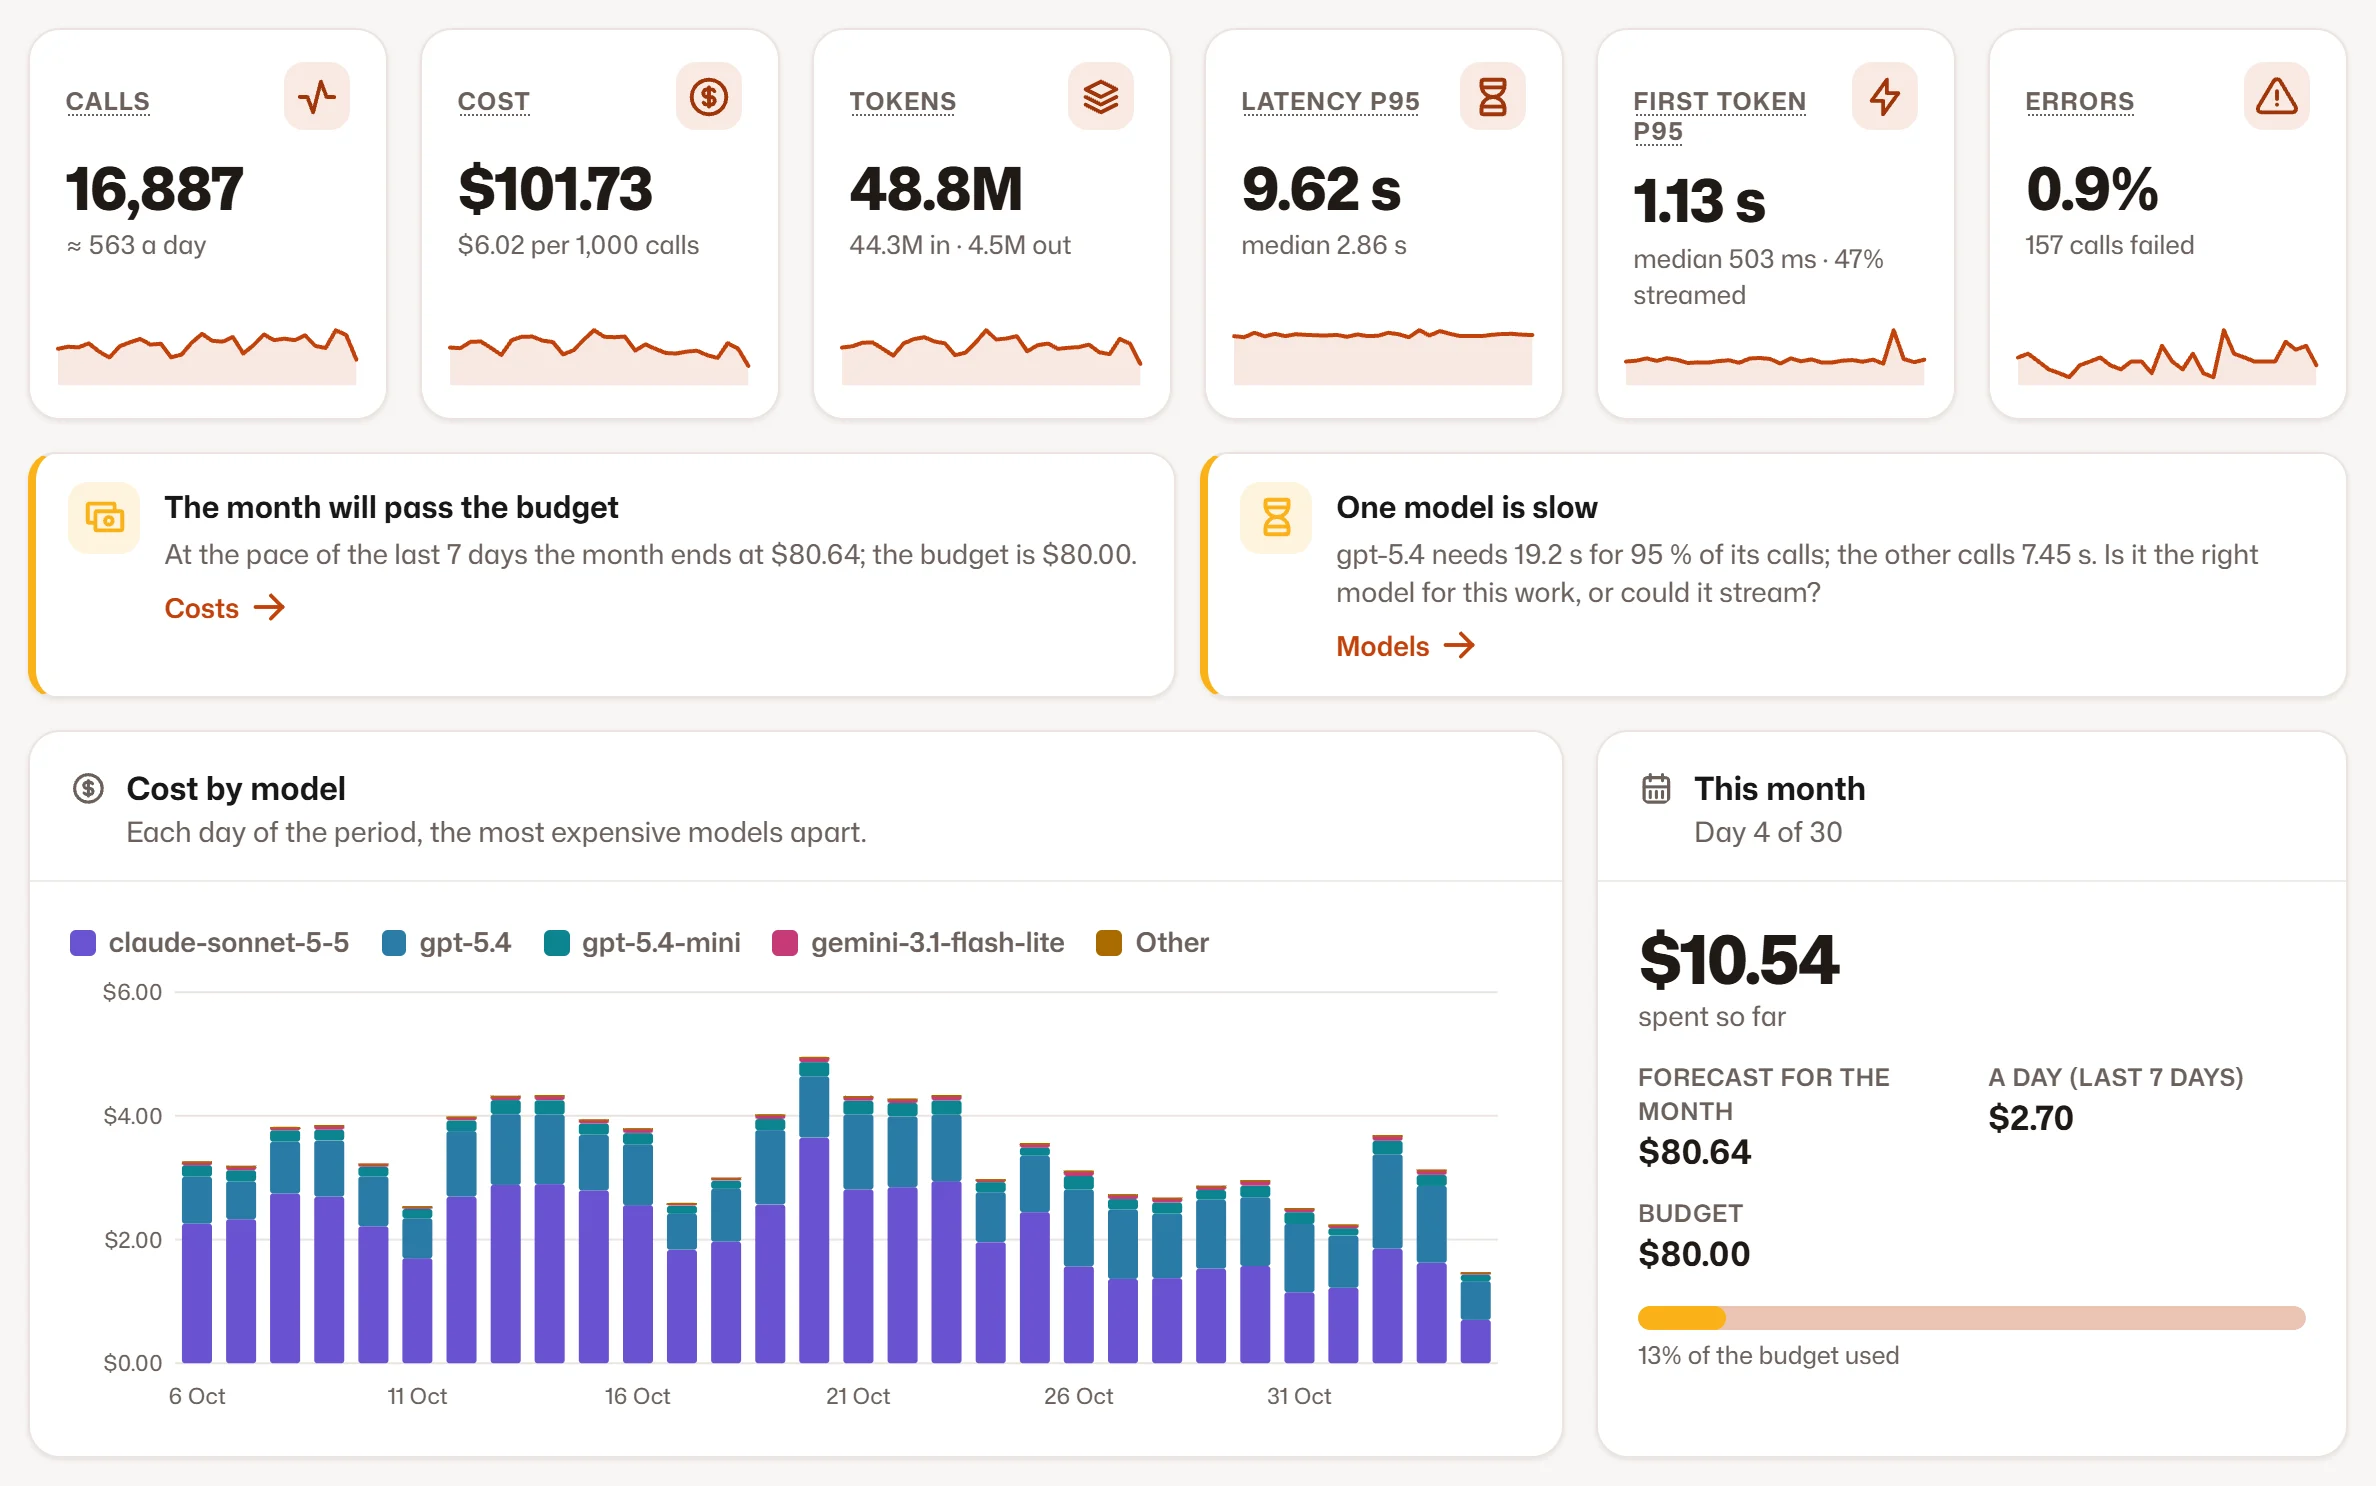
Przegląd twojego AI
II.

Jedno żądanie, krok po kroku

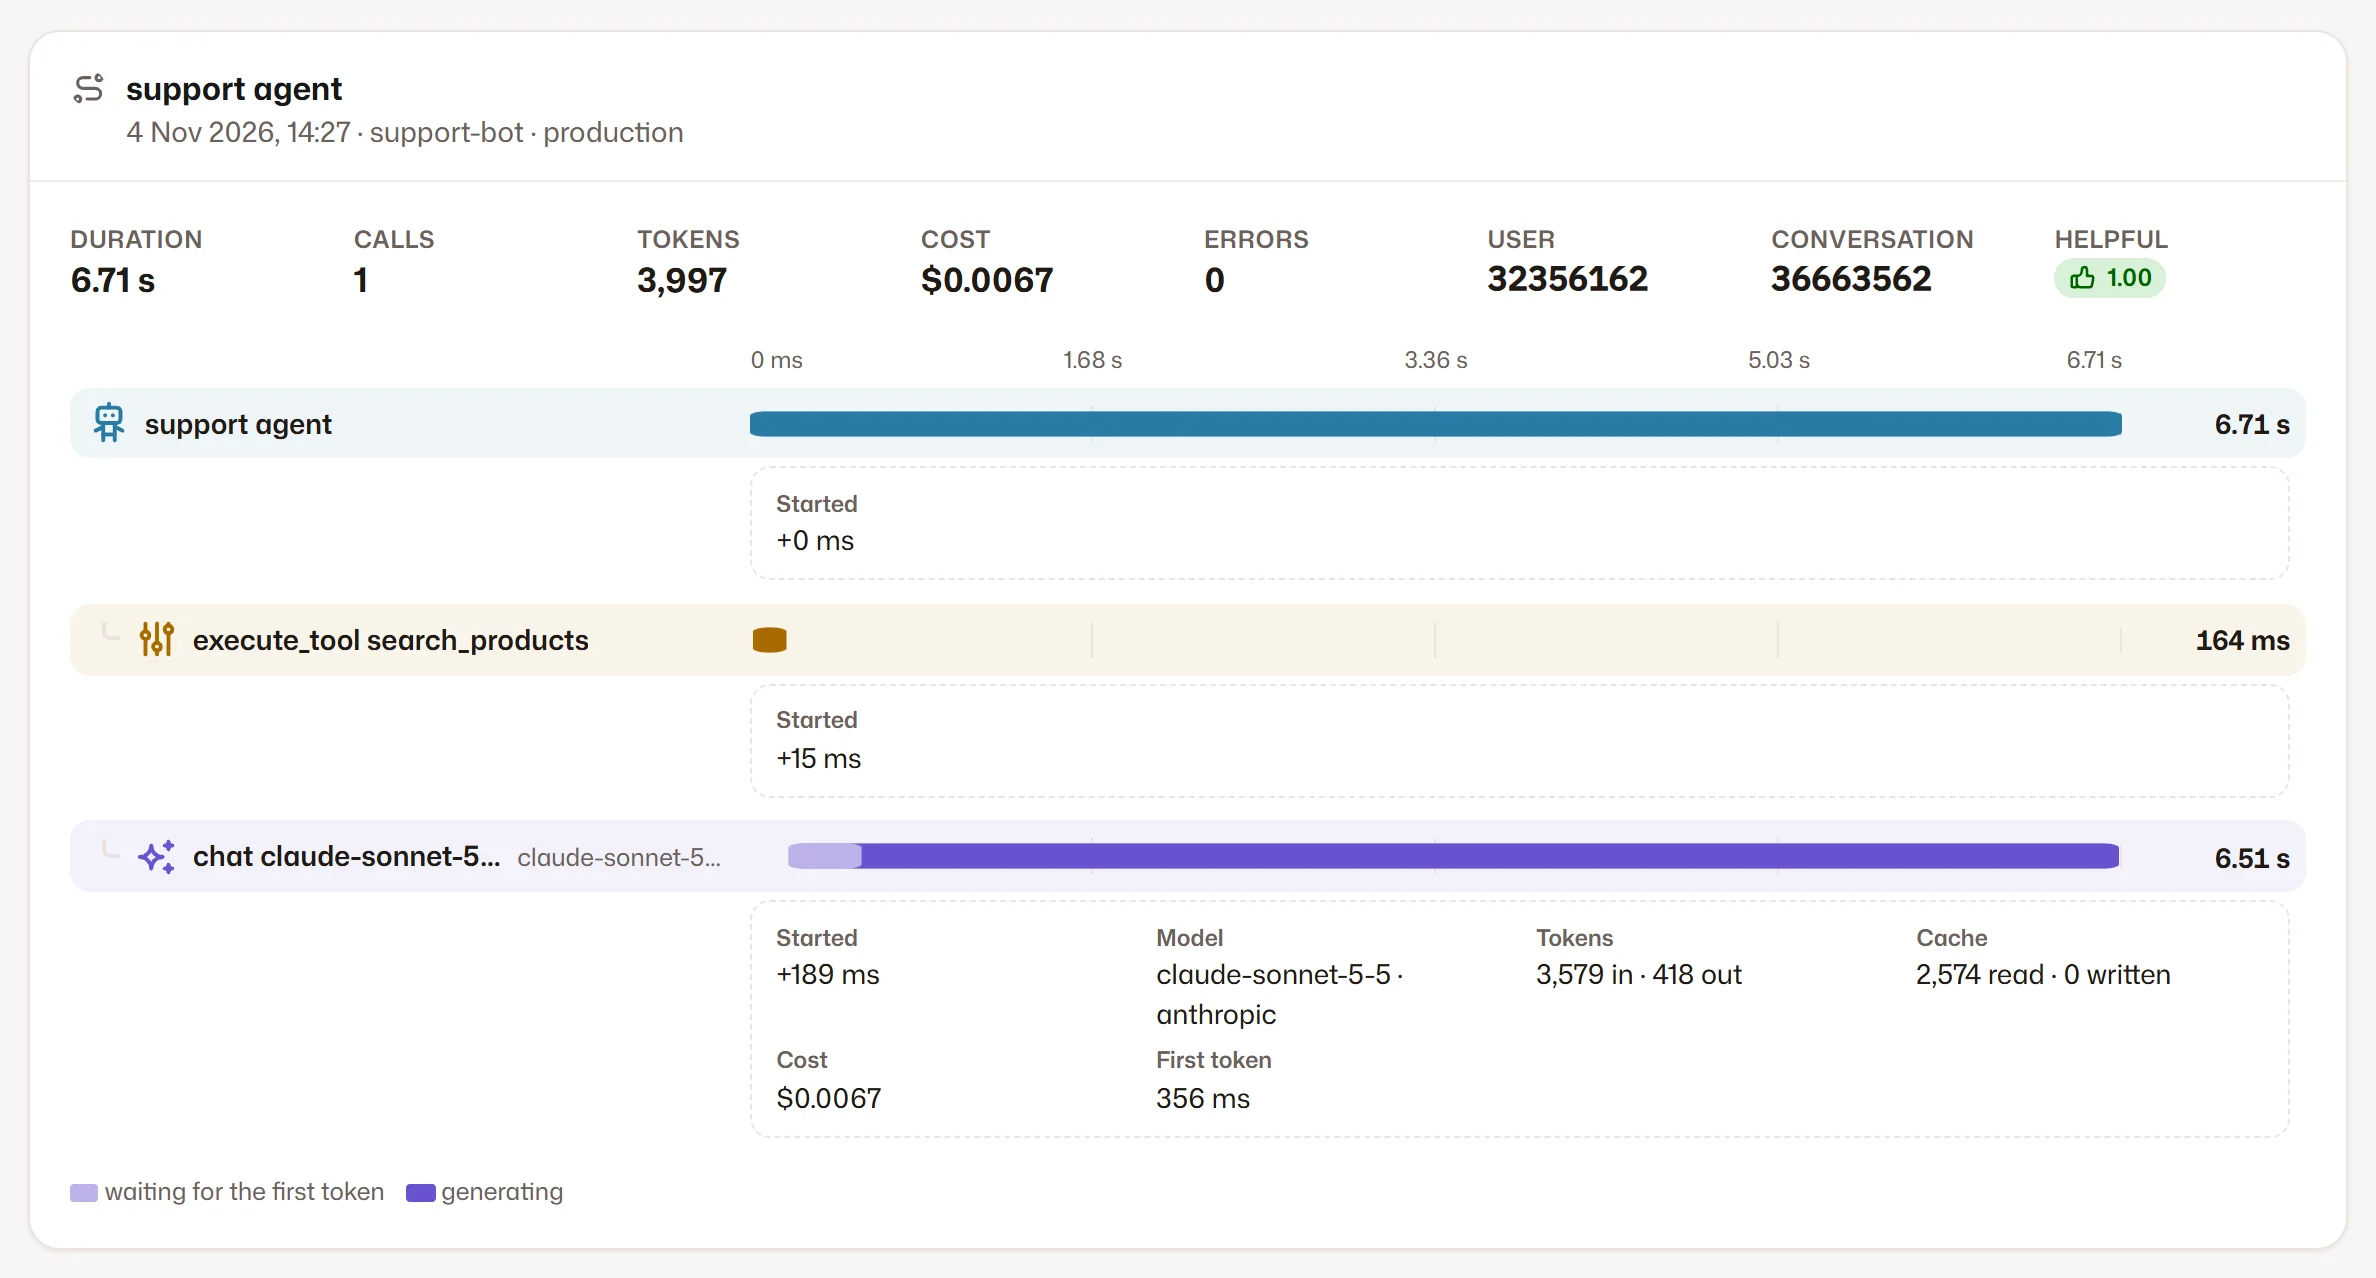
Każde żądanie twojej aplikacji to ślad. Jego kaskada pokazuje w czasie agenta, narzędzia, pobieranie danych i wywołania modelu, z tokenami, kosztem, pierwszym tokenem i kodem błędu każdego wywołania. Promptów i odpowiedzi tam nie ma, bo nigdy nie zostały zapisane.

  1. 1Sumy śladu i jego ocena
  2. 2Kroki w czasie
Jedno żądanie, krok po kroku
III.

Modele obok siebie

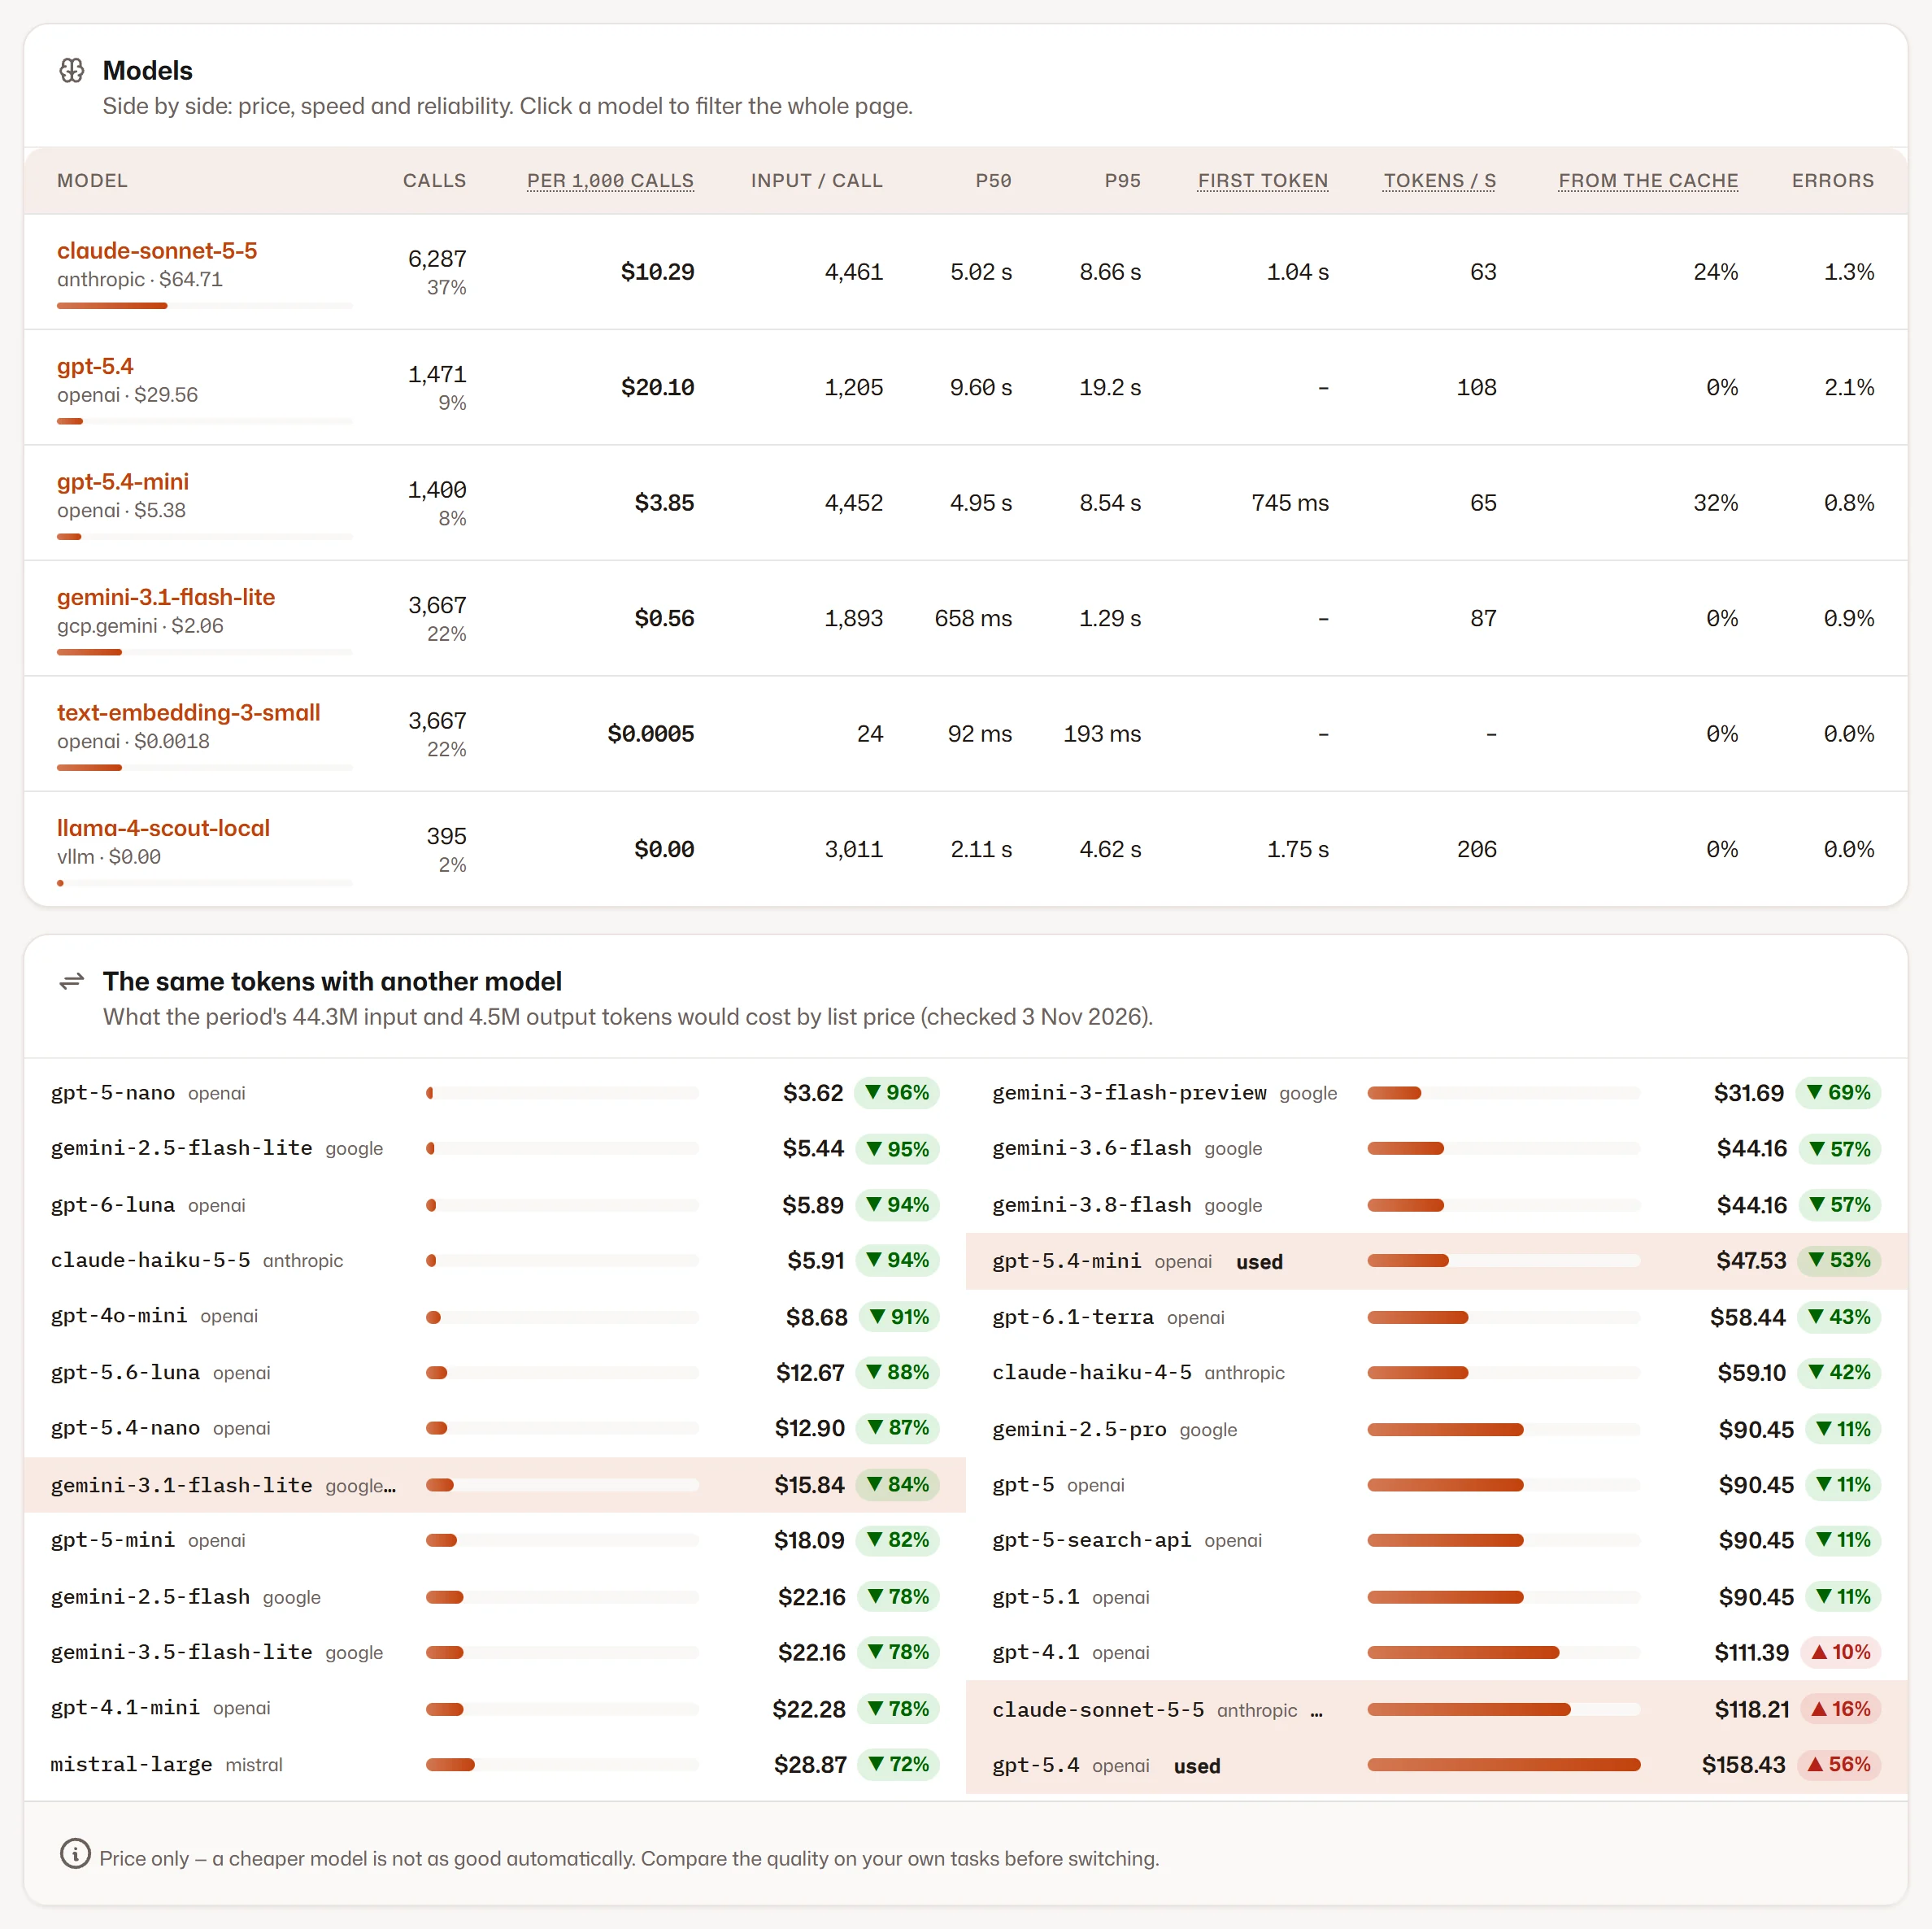
Cena za 1000 wywołań, p50 i p95, pierwszy token, tokeny na sekundę, użycie pamięci podręcznej i błędy, wszystko z twojego własnego ruchu. Pod spodem to, ile kosztowałyby te same tokeny z innym modelem z cennika.

  1. 1Porównanie twoich modeli
  2. 2Te same tokeny z innym modelem
Modele obok siebie
IV.

Wersje promptu

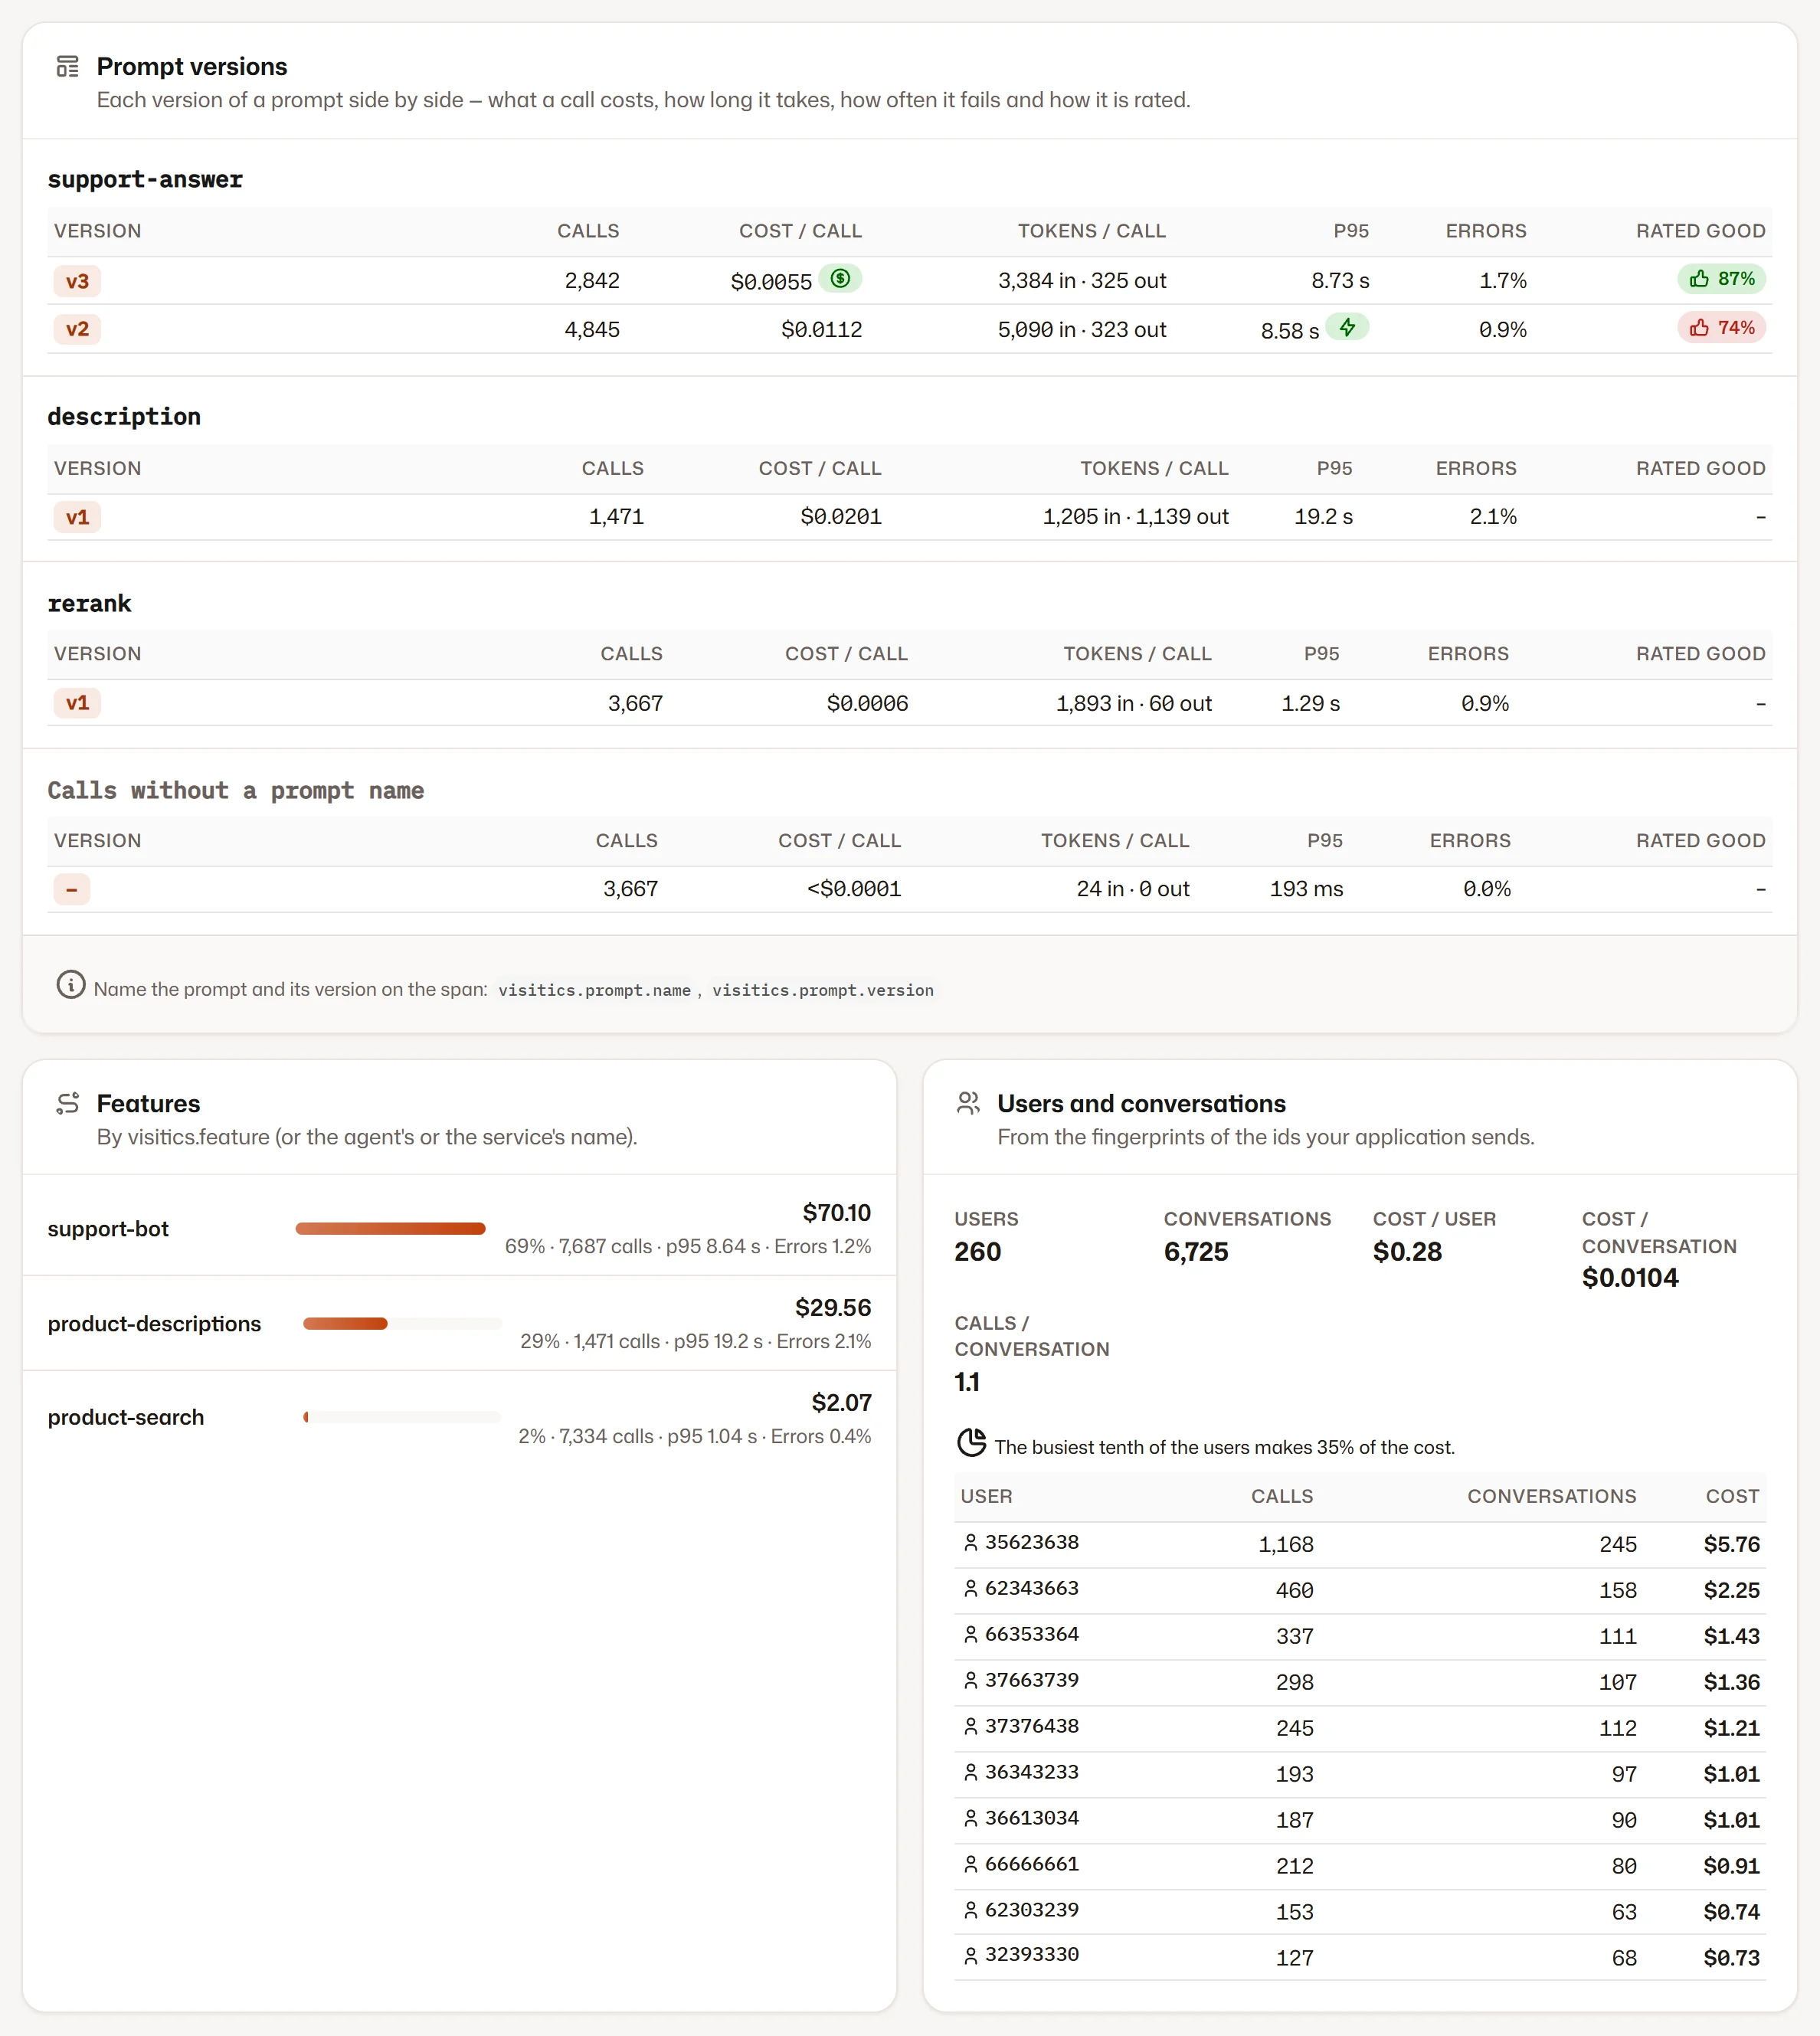
Przy wywołaniu modelu podaj nazwę promptu i jego wersję, a każda wersja dostanie własny wiersz: koszt wywołania, tokeny, p95, błędy i to, jak ludzie ocenili odpowiedzi. Funkcje, użytkownicy i rozmowy są na tej samej karcie.

  1. 1Wersje promptów obok siebie
  2. 2Funkcje twojej aplikacji
  3. 3Użytkownicy i rozmowy, tylko jako odciski
Wersje promptu
V.

Połączone w trzech krokach

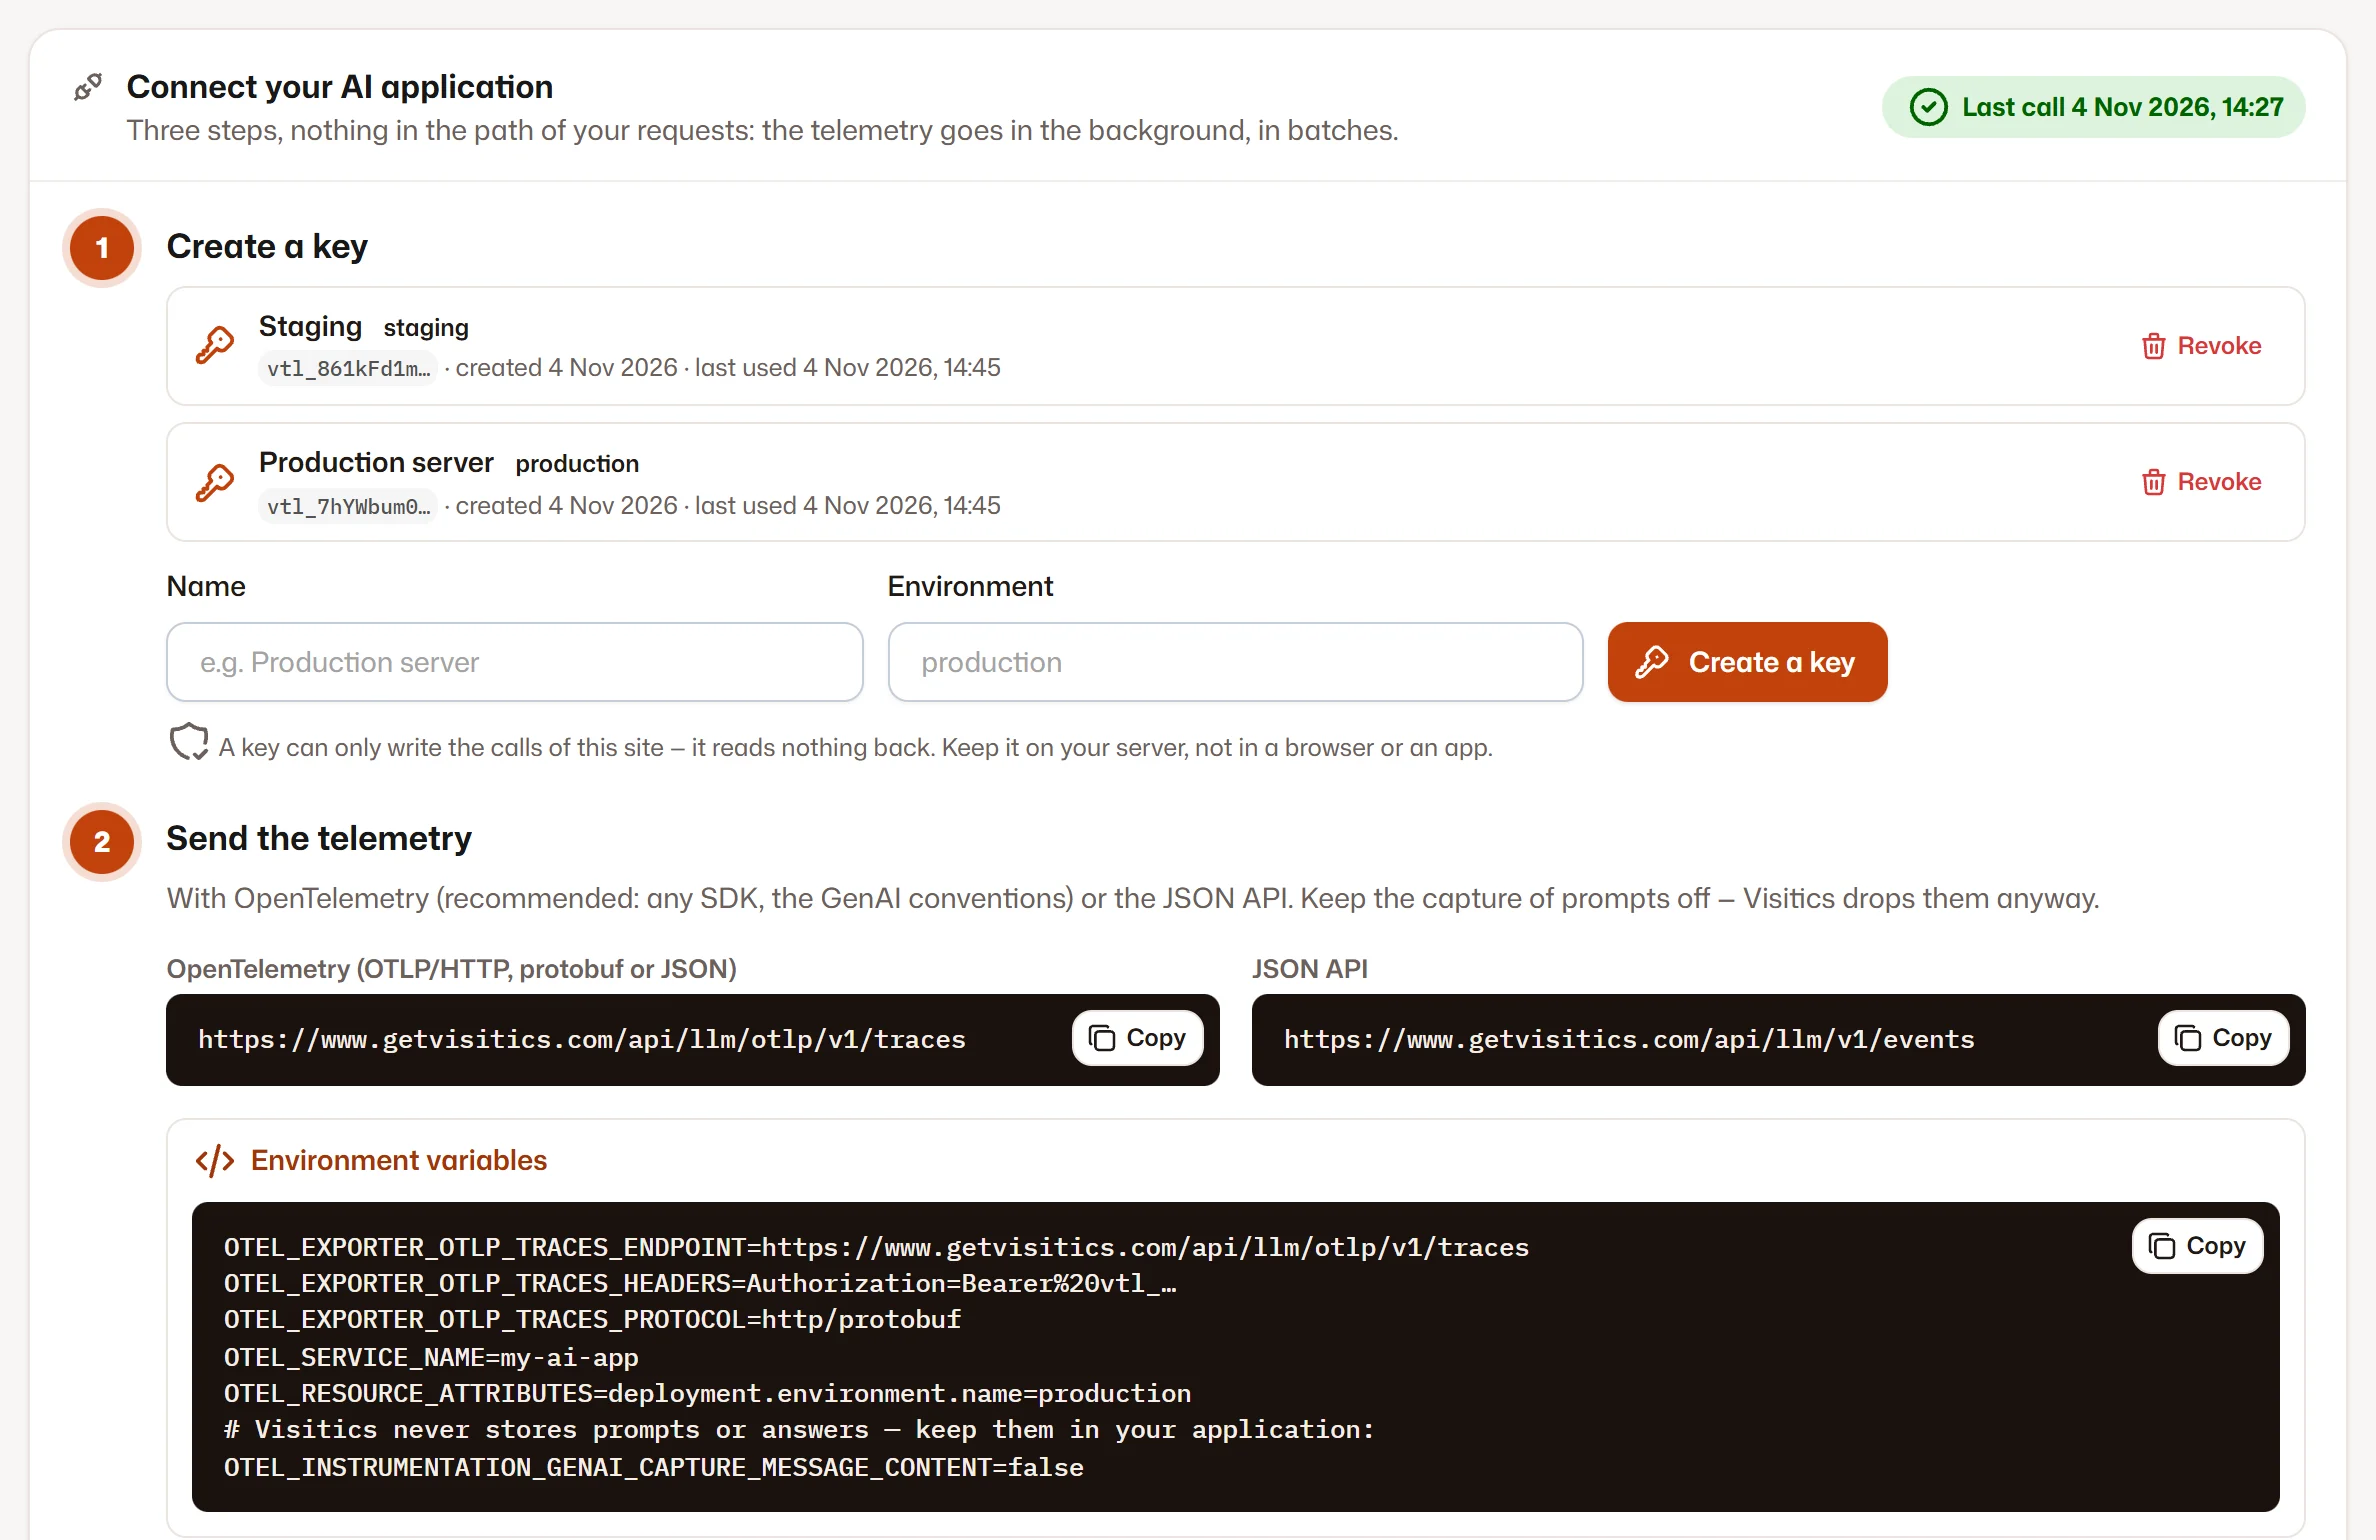
Utwórz klucz tylko do zapisu, skieruj aplikację na Visitics i wykonaj kilka wywołań: pojawią się w ciągu kilku sekund. Nic nie stoi na drodze twoich żądań, a instrukcja zostawia zbieranie promptów wyłączone.

  1. 1Klucze tylko do zapisu dla każdego środowiska
  2. 2Adresy dla OpenTelemetry i API JSON
  3. 3Gotowy kod dla zmiennych środowiskowych, Pythona, Node.js i curl
Połączone w trzech krokach

Zrzuty ekranu panelu Visitics z danymi demonstracyjnymi.

Szczegóły

Jak to działa od środka

OpenTelemetry zamiast nowego SDK

Visitics przyjmuje konwencje OpenTelemetry GenAI przez OTLP/HTTP, jako protobuf lub JSON, także skompresowane gzipem. Aplikacji z instrumentacją wystarczy adres i klucz, a wszystko inne, co eksportuje, na przykład żądania HTTP czy zapytania do bazy danych, jest pomijane.

API JSON do prostych przypadków

Jedno żądanie POST z maksymalnie 500 wywołaniami: model, tokeny, czasy i nazwy, które wybierzesz. Obiekty usage z OpenAI, Anthropic i Gemini są odczytywane w takiej postaci, w jakiej przychodzą, a drugi punkt końcowy przyjmuje oceny odpowiedzi, na przykład kciuk w górę lub w dół.

Poza drogą twoich żądań

Visitics nie jest proxy i nie wydłuża żadnego wywołania. OpenTelemetry wysyła partiami w tle, Visitics odpowiada od razu i zapisuje dopiero potem, a partia wysłana dwa razy liczy się raz.

Koszty według rodzaju tokenów

Wejście, odczyt z pamięci podręcznej, zapis do niej i wyjście mają każde swoją cenę. Koszt pochodzi z datowanego cennika OpenAI, Anthropic, Google i Mistral, z twoich własnych cen albo z twojej aplikacji. Model bez ceny pojawia się jako nieznany, a nie jako zero.

Wskazówki poparte liczbami

Przegląd mówi, na co spojrzeć, i podaje liczbę, która za tym stoi: miesiąc zmierzający ponad budżet, koszt rosnący przez więcej wywołań lub droższe wywołania, więcej błędów, wolny model, wolny pierwszy token, pamięć podręczna promptów, która by zaoszczędziła, droższa wersja promptu.

AI obok twoich celów

Gdy twój serwer wyśle z wywołaniem adres IP i przeglądarkę odwiedzającego, Visitics zrobi z nich ten sam dzienny odcisk co przy wizycie i nie zapisze ani jednego, ani drugiego. Zobaczysz wtedy, czy odwiedzający, którzy użyli twojego AI, osiągają cele częściej niż pozostali: to korelacja, a nie dowód. Bez tego i bez skryptu pomiarowego cała reszta działa tak samo.

Co potrafi

Wszystko, co obejmuje funkcja AI Observability

  • Wywołania, tokeny, koszt w dolarach amerykańskich, opóźnienie, pierwszy token i błędy ze zmianą względem poprzedniego okresu
  • Okresy 24 godzin, 7, 30 i 90 dni, filtry według środowiska, dostawcy, modelu i funkcji
  • Wskazówki: rosnące koszty, więcej błędów, wolny model, pamięć podręczna promptów, która by zaoszczędziła, droższa wersja promptu
  • Ślady jako kaskada agentów, wywołań modelu, narzędzi i pobierania danych, z listami nieudanych, najwolniejszych i najdroższych
  • Porównanie modeli: koszt na 1000 wywołań, p50, p95, pierwszy token, tokeny na sekundę, użycie pamięci podręcznej i błędy
  • Ile kosztowałyby te same tokeny z innym modelem z cennika
  • Wersje promptów obok siebie, z ocenami odpowiedzi wysyłanymi przez twoją aplikację
  • Koszt według funkcji, rodzaju tokenów i dnia, na użytkownika i na rozmowę
  • Miesięczny budżet z prognozą na miesiąc i e-maile przy 80 % i 100 %
  • Klucze tylko do zapisu dla każdego środowiska, które możesz w każdej chwili unieważnić

Prywatność

Co jest zapisywane — a co nie

Zapisywane

  • Liczby każdego wywołania: tokeny, czasy, koszt i to, czy się nie powiodło
  • Nazwy wysyłane przez twoją aplikację: model, funkcja, nazwa i wersja promptu, środowisko
  • Odciski identyfikatorów użytkowników i rozmów, nigdy same identyfikatory

Nigdy niezapisywane

  • Prompty, odpowiedzi, instrukcje ani argumenty i wyniki narzędzi
  • Treść komunikatów o błędach: błąd zostaje tylko jako krótki kod
  • Adres IP ani przeglądarka odwiedzającego, które służą tylko do dziennego odcisku, jeśli je wyślesz

Jak Visitics mierzy bez cookies

Plany

AI Observability w planach

Wartości pochodzą prosto z cennika. Każda nowa organizacja testuje Aurę za darmo przez 14 dni, bez karty płatniczej.

AI Observability w planach
Novaza darmo bez limitu czasu Pulse9 € miesięcznie Aura29 € miesięcznie Luna79 € miesięcznie
Wywołania AI miesięcznie ze szczegółami 10 000 100 000 1 000 000 5 000 000
Przechowywanie szczegółów 30 dni 30 dni 30 dni 30 dni
E-mail przy 80 % i 100 % budżetu Brak w tym planie W pakiecie W pakiecie W pakiecie
Zacznij za darmo Wybierz plan Pulse Wybierz plan Aura Wybierz plan Luna

Zobacz cennik

Pytania

Najczęstsze pytania: AI Observability

Czy to to samo co analityka AI i LLM?

Nie. AI Observability, znane też jako obserwowalność LLM, mierzy AI, które wywołuje twoja własna aplikacja: ile kosztuje, jak jest szybkie i jak często zawodzi. Analityka AI i LLM mierzy coś innego: wizyty, które asystenci tacy jak ChatGPT kierują na twoją stronę, oraz roboty AI, które ją czytają.

Czy Visitics zapisuje moje prompty i odpowiedzi?

Nie. Prompty, odpowiedzi, instrukcje i dane narzędzi są odrzucane już przy odczycie żądania, API JSON nie ma dla nich pól, a instrukcja konfiguracji każe twojemu SDK w ogóle ich nie wysyłać. Żaden plan ani ustawienie tego nie zmienia.

Czy Visitics stoi między moją aplikacją a modelem?

Nie, to nie jest proxy. Twoja aplikacja wywołuje model jak dotąd, a telemetrię wysyła osobno, partiami w tle. Gdy Visitics jest niedostępny, twoje wywołania działają normalnie; może zabraknąć tylko ich telemetrii.

Które modele i SDK działają?

Każdy model, który zgłosi twoja aplikacja. Visitics odczytuje konwencje OpenTelemetry GenAI, więc instrumentacje takie jak OpenLLMetry i Vercel AI SDK mogą wysyłać do niego bezpośrednio, a w konfiguracji jest gotowy kod dla zmiennych środowiskowych, Pythona, Node.js i API JSON. Cennik obejmuje OpenAI, Anthropic, Google i Mistral; każdemu innemu modelowi, na przykład na własnym serwerze, podasz własną cenę.

Jak dokładne są koszty?

To szacunek na podstawie tokenów każdego rodzaju i cen katalogowych dostawców. Każda cena ma swoją datę, więc późniejsza zmiana nie przepisuje minionych dni. Przy cenie wynegocjowanej podaj własną albo niech aplikacja wysyła koszt razem z wywołaniem. Ostatnie słowo należy do faktury dostawcy.

Co się stanie, gdy osiągnę limit planu?

Nic się nie zatrzyma. Wywołania ponad limit są nadal sumowane, więc koszty, tokeny i liczby pozostają pełne; tylko ich szczegóły, takie jak kaskada, nie są zachowywane do końca miesiąca.

Jak długo przechowywane są dane?

Szczegóły każdego wywołania zostają na 30 dni. Dzienne podsumowania są przechowywane zgodnie z historią twojego planu, a strona pokazuje najwyżej ostatnie 90 dni. Wszystko zostaje w UE i znika, gdy usuniesz stronę.

Wypróbuj na swojej stronie: AI Observability

Klucz i kilka linii konfiguracji, a pierwsze wywołania pojawią się w kilka sekund. Aura za darmo przez 14 dni, potem Nova bez limitu czasu — bez karty płatniczej.