Saltar al contenido
Visiticsby esentra
ES

Gratis en Nova y en todos los planes

AI Observability: cuánto cuesta su IA y cómo funciona

Su aplicación llama a OpenAI, Anthropic, Google, Mistral o a su propio modelo. Visitics muestra cuánto cuesta cada llamada, qué rápida es y con qué frecuencia falla, por modelo, función y versión del prompt. Solo conserva cifras y nombres: los prompts y las respuestas no se guardan nunca.

Para qué sirve

En qué le ayuda

  1. 01

    Costes que puede explicar

    En lugar de una suma en la factura del proveedor, ve el coste por modelo, función, versión del prompt y usuario, con un presupuesto mensual y una previsión del mes.

  2. 02

    Velocidad y errores en un solo lugar

    La latencia p50 y p95, el tiempo hasta el primer token y los errores de cada modelo, y cada petición como una cascada de sus pasos.

  3. 03

    Cifras, nunca contenido

    Los prompts y las respuestas se descartan antes de escribir nada, y ningún ajuste lo cambia. Visitics no guarda las conversaciones de sus usuarios.

Cómo funciona

Pantallas reales del panel

I.

El resumen de su IA

Seis cifras con su cambio respecto al periodo anterior, qué mirar primero y el coste de cada día por modelo. Filtre toda la página por entorno, proveedor, modelo o función.

  1. 1Llamadas, coste, tokens, latencia, primer token y errores
  2. 2Qué mirar, con la cifra que hay detrás
  3. 3El coste por modelo, día a día
  4. 4El mes hasta ahora, su previsión y su presupuesto
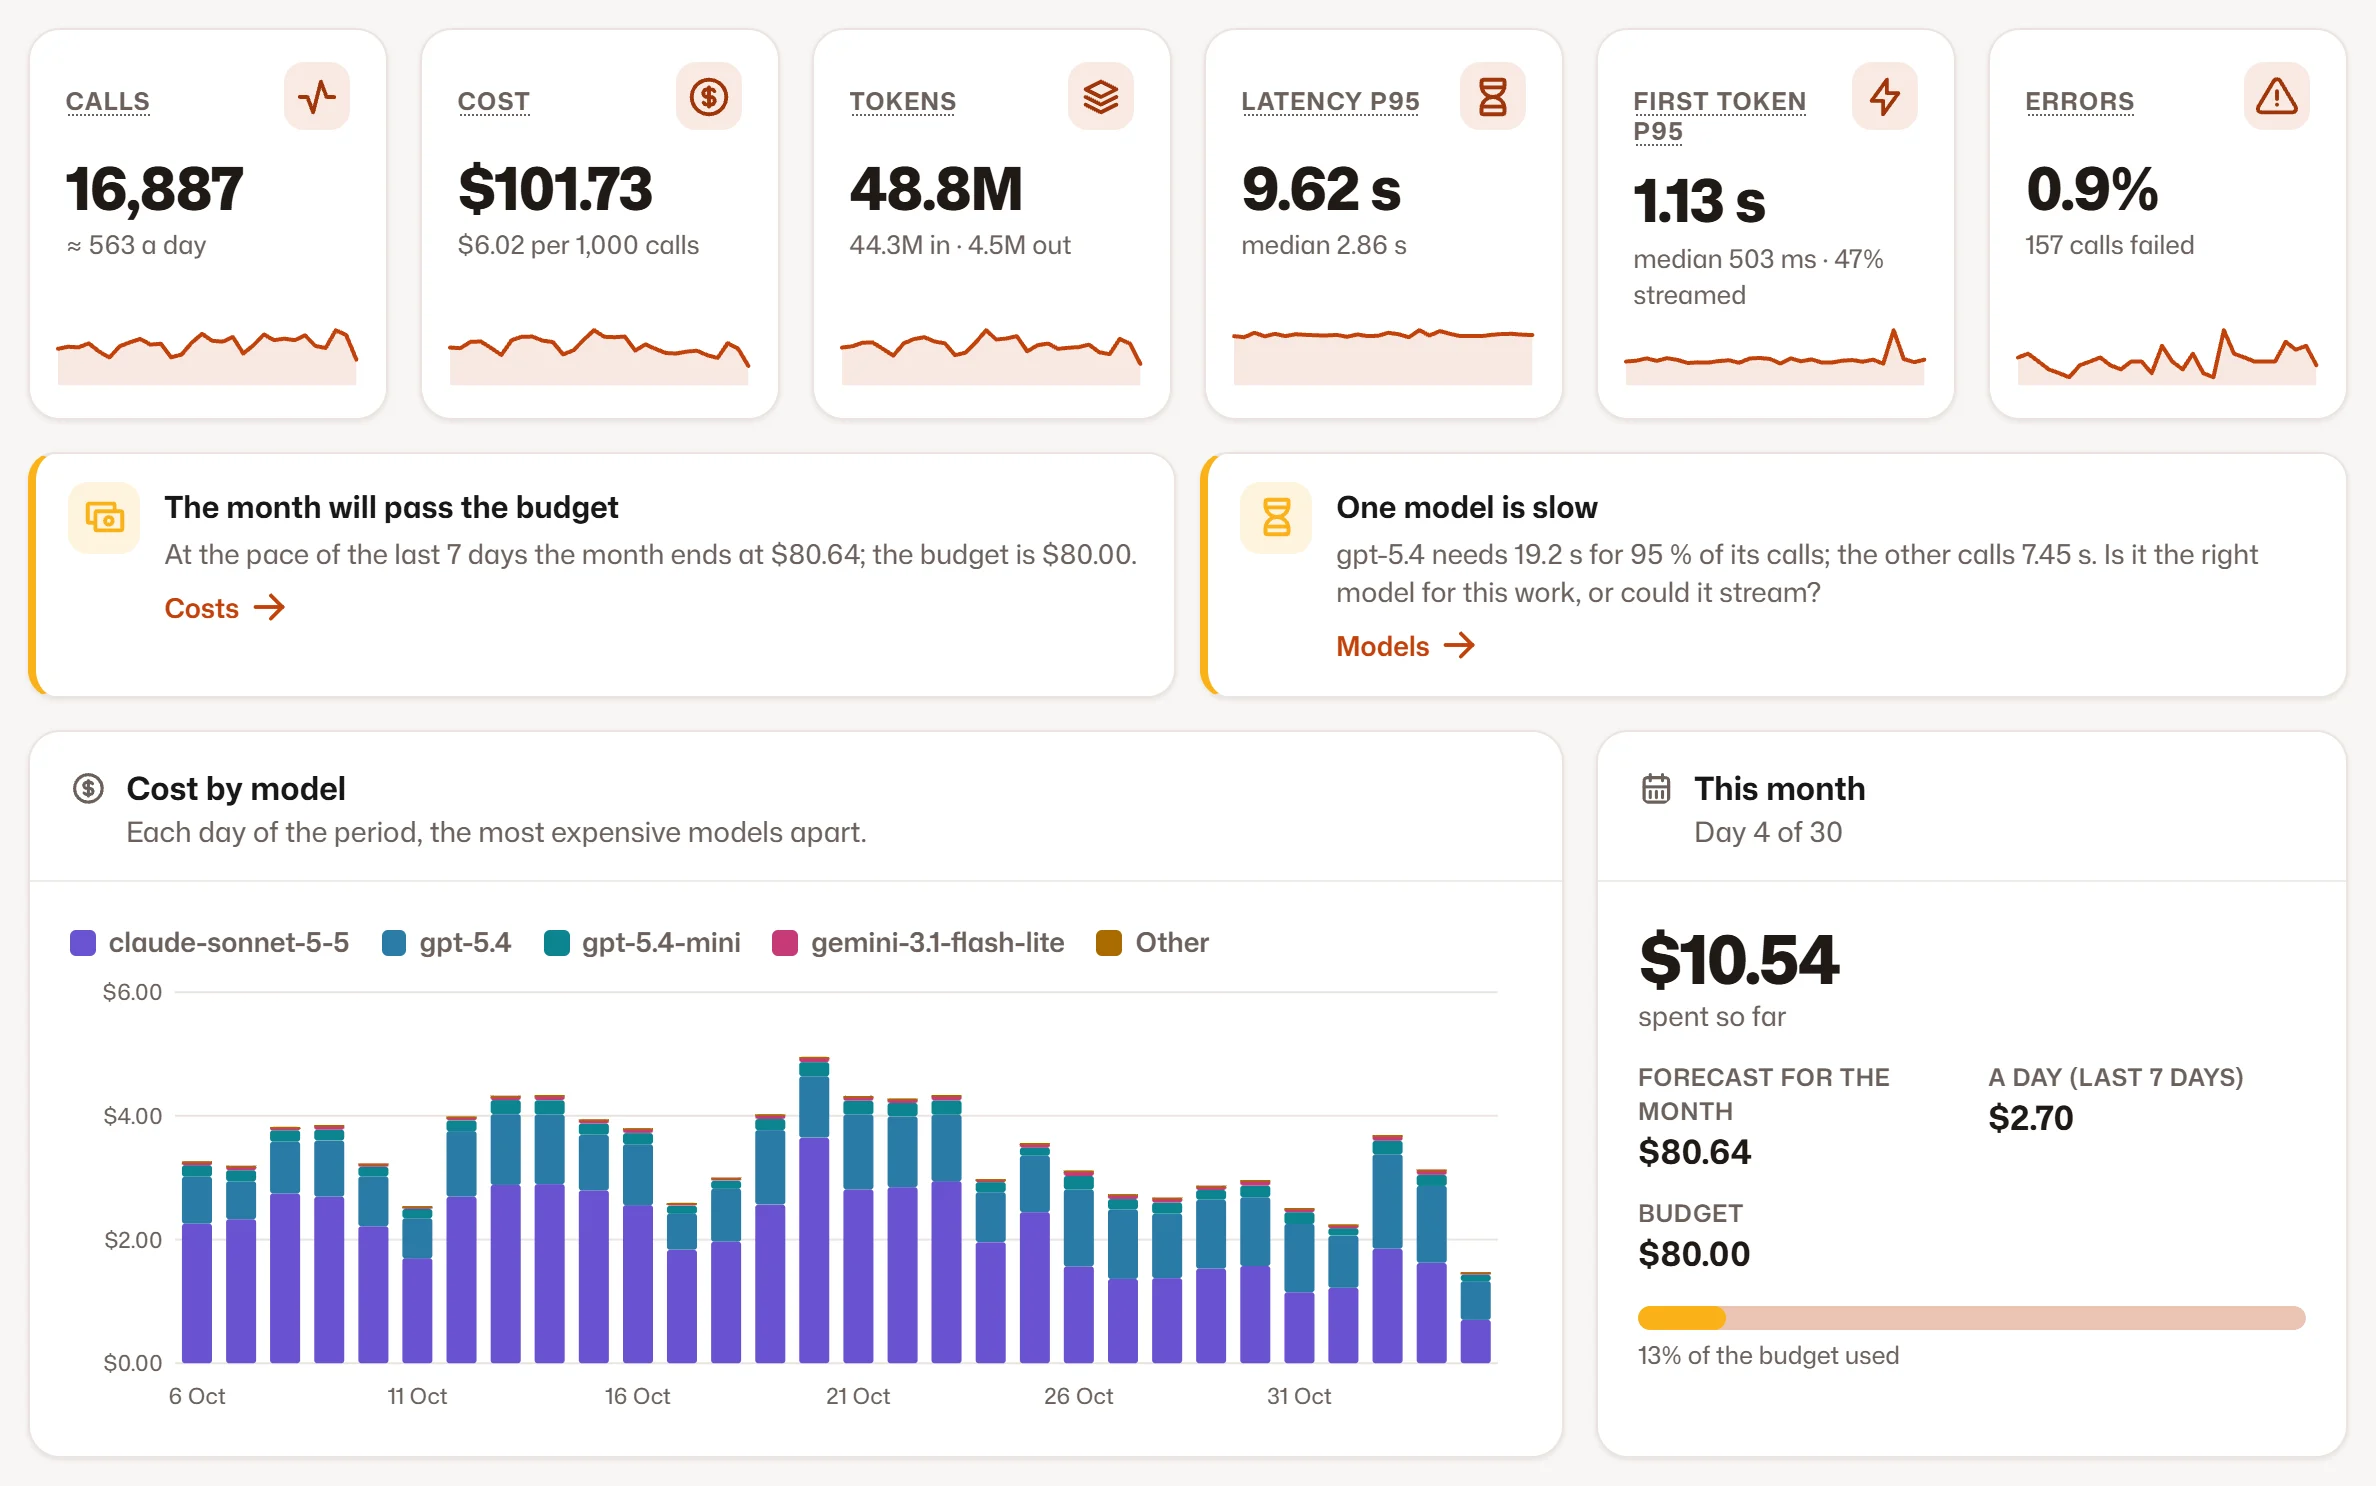
El resumen de su IA
II.

Una petición, paso a paso

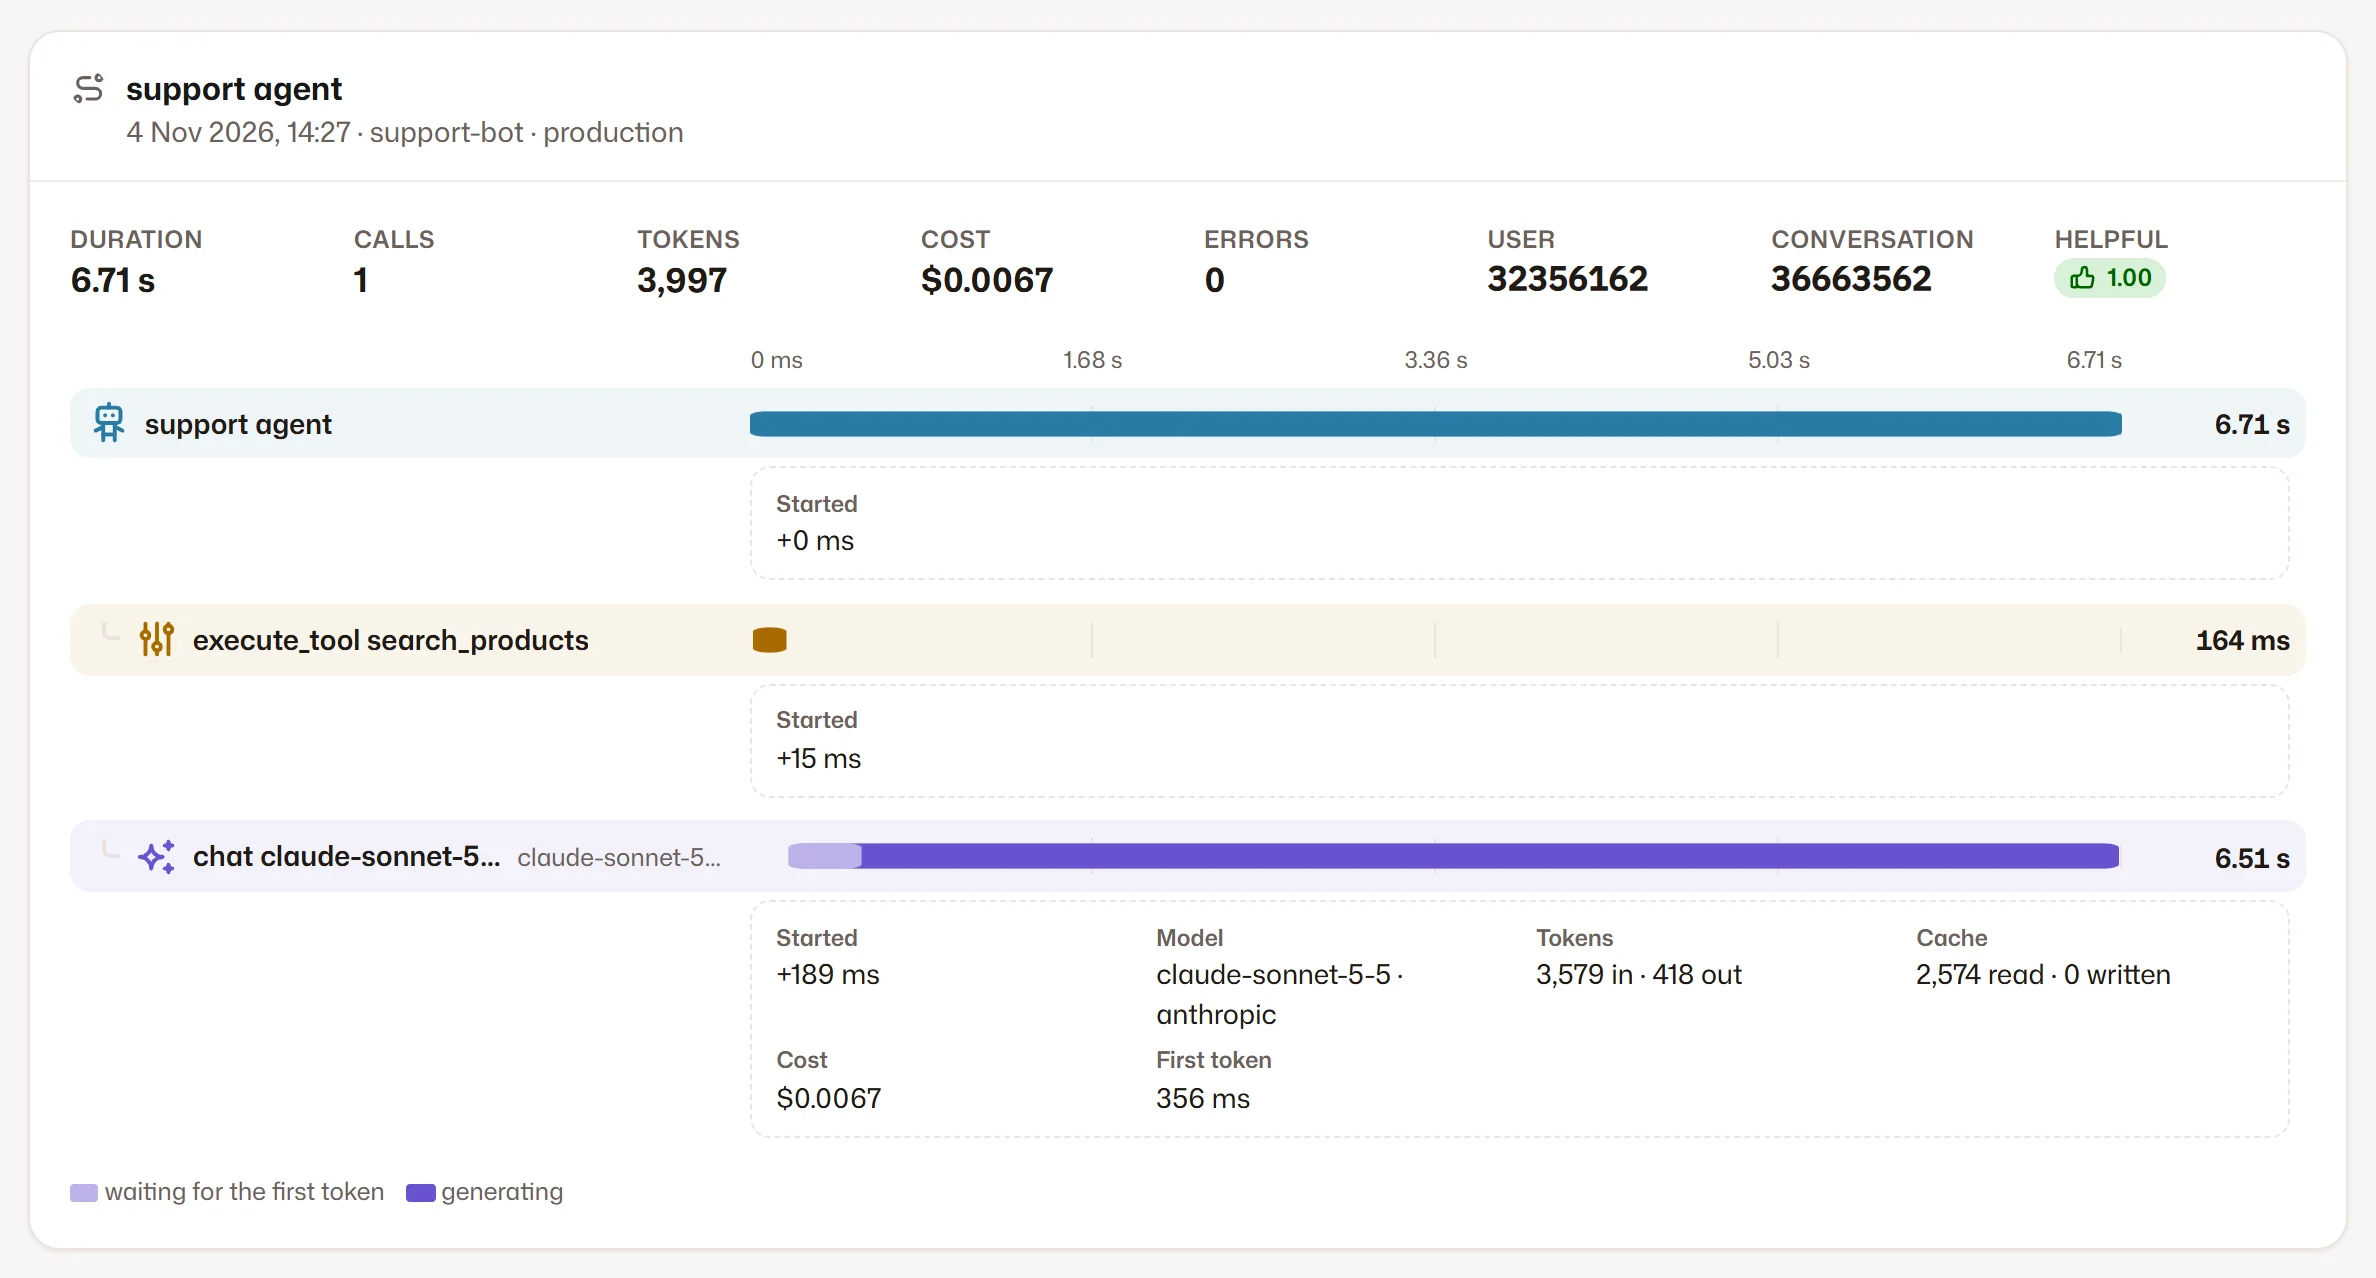
Cada petición de su aplicación es una traza. Su cascada muestra en el tiempo el agente, las herramientas, la recuperación de datos y las llamadas al modelo, con los tokens, el coste, el primer token y el código de error de cada llamada. Los prompts y las respuestas no están ahí, porque nunca se guardaron.

  1. 1Los totales de la traza y su valoración
  2. 2Los pasos en el tiempo
Una petición, paso a paso
III.

Modelos lado a lado

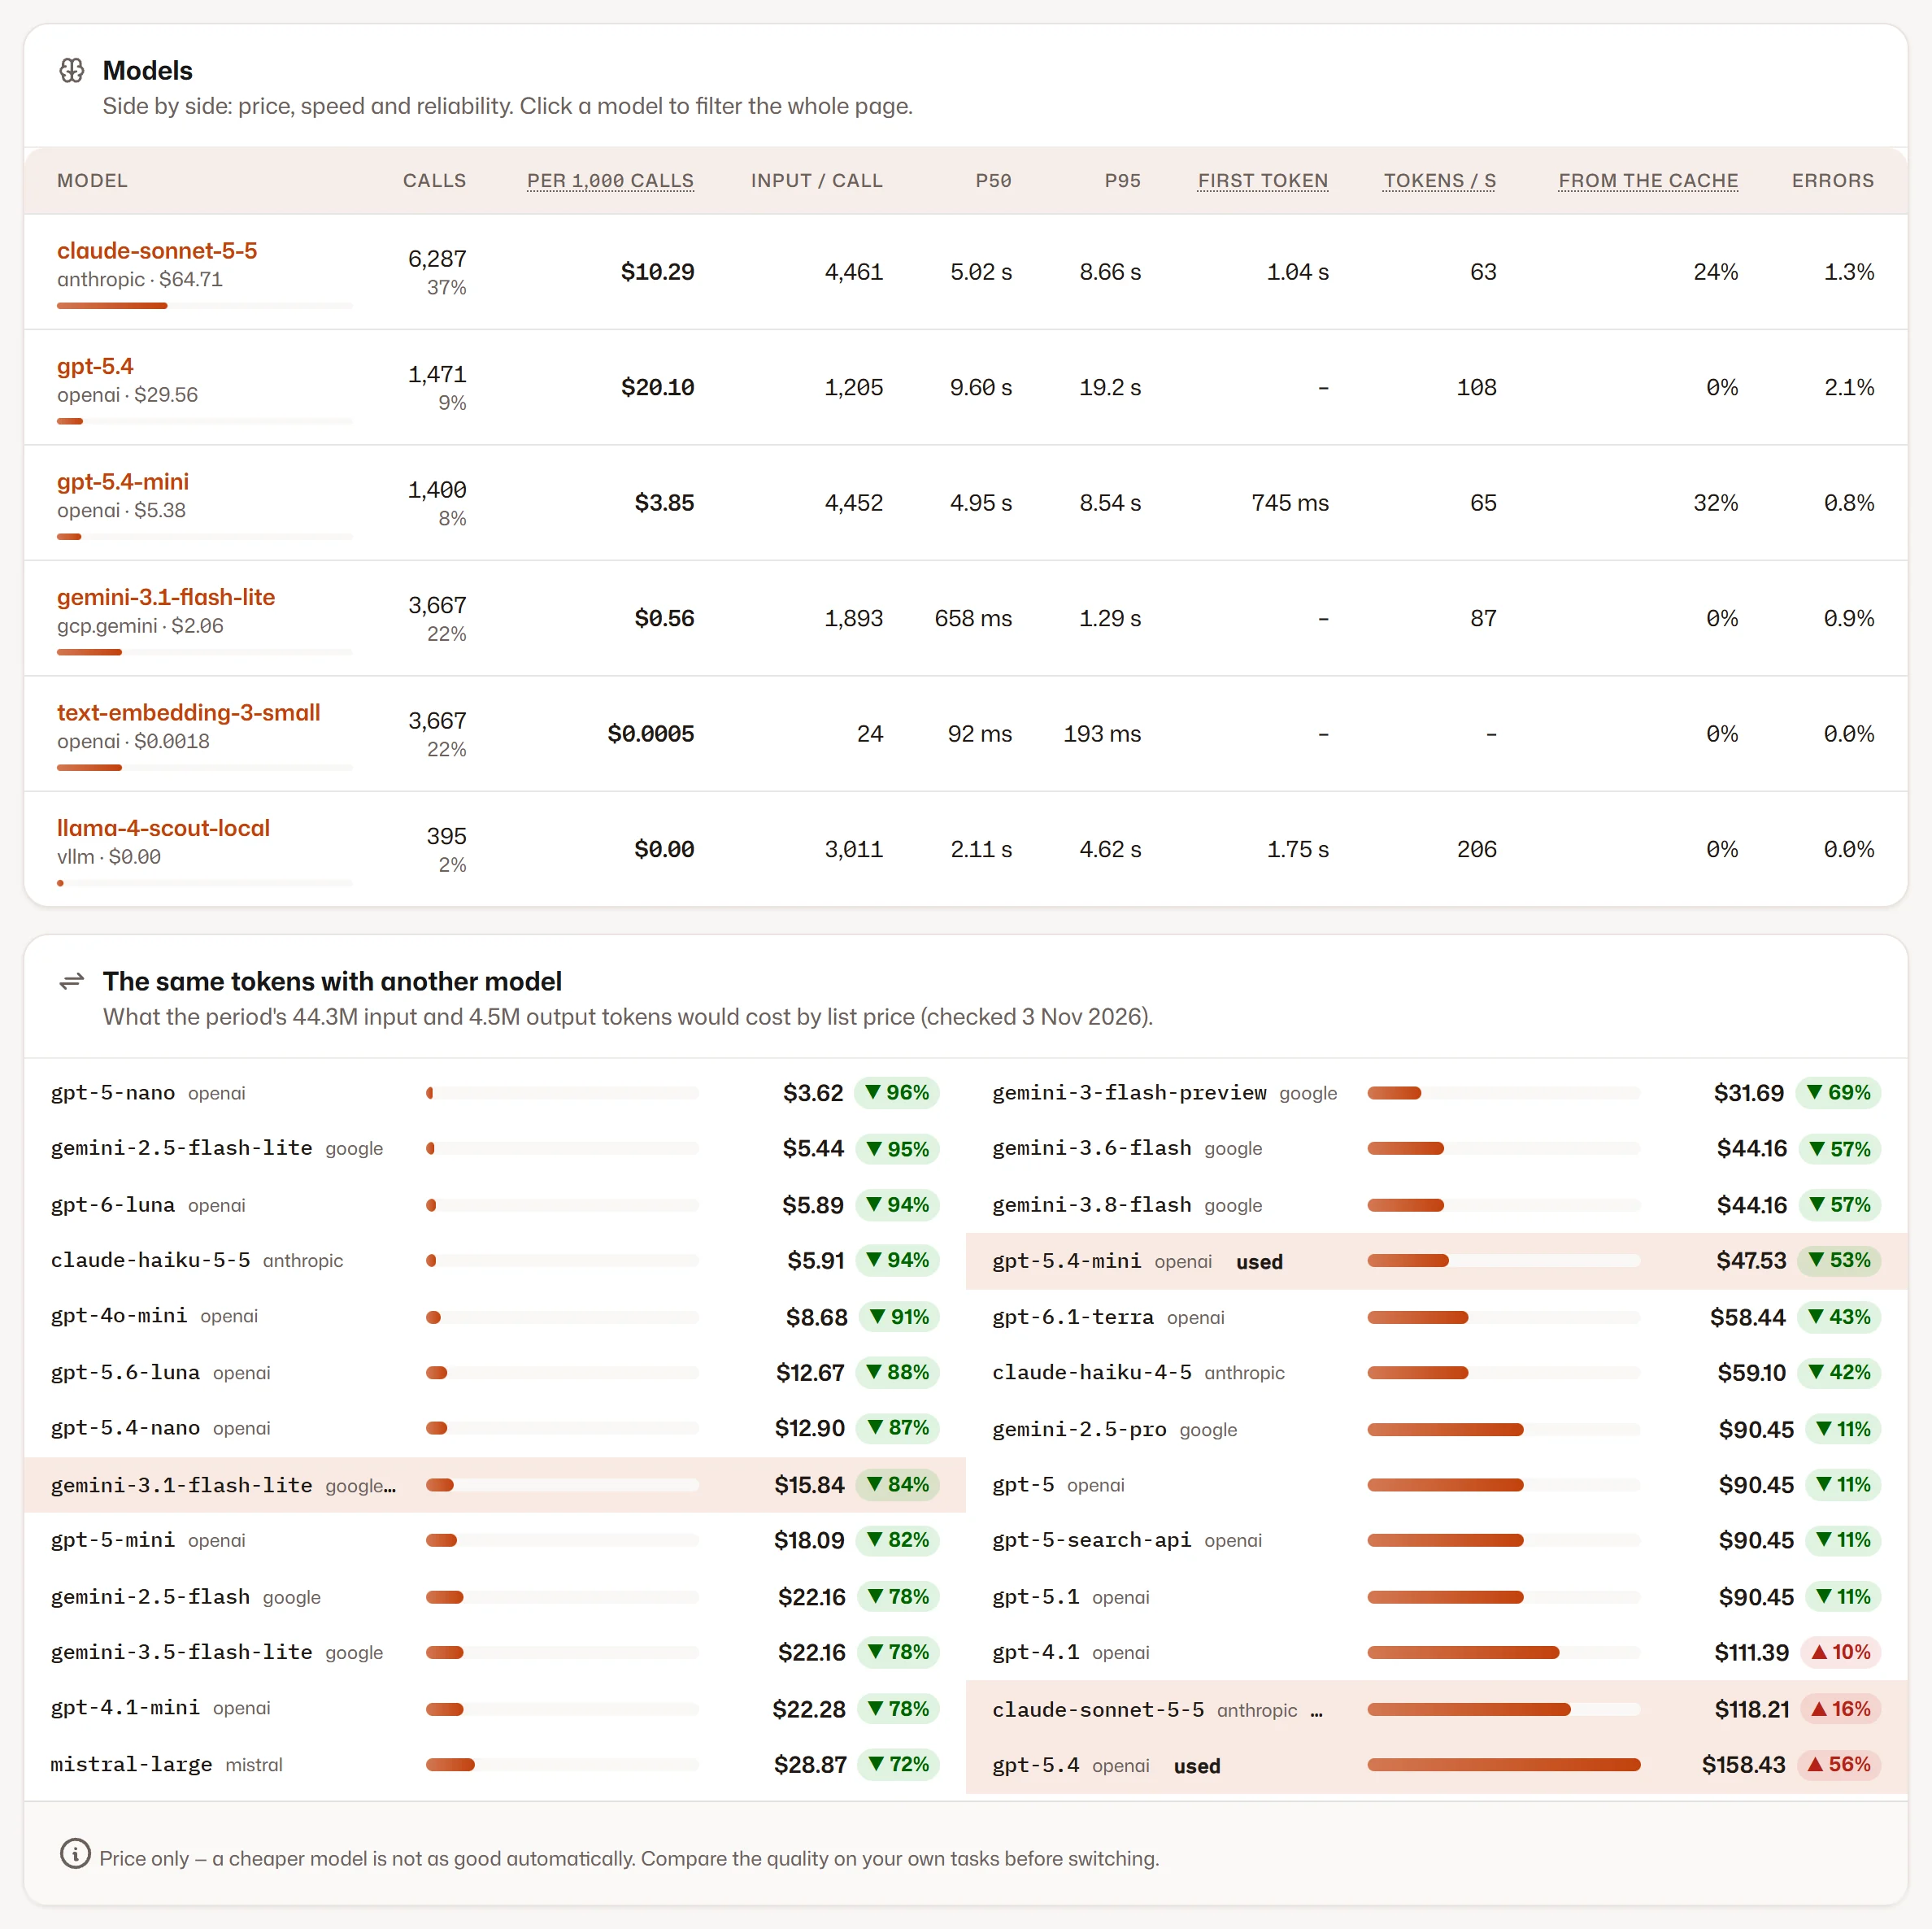
El precio por 1000 llamadas, p50 y p95, el primer token, los tokens por segundo, el uso de la caché y los errores, todo con su propio tráfico. Debajo, lo que costarían los mismos tokens con otro modelo de la lista de precios.

  1. 1Sus modelos comparados
  2. 2Los mismos tokens con otro modelo
Modelos lado a lado
IV.

Las versiones de un prompt

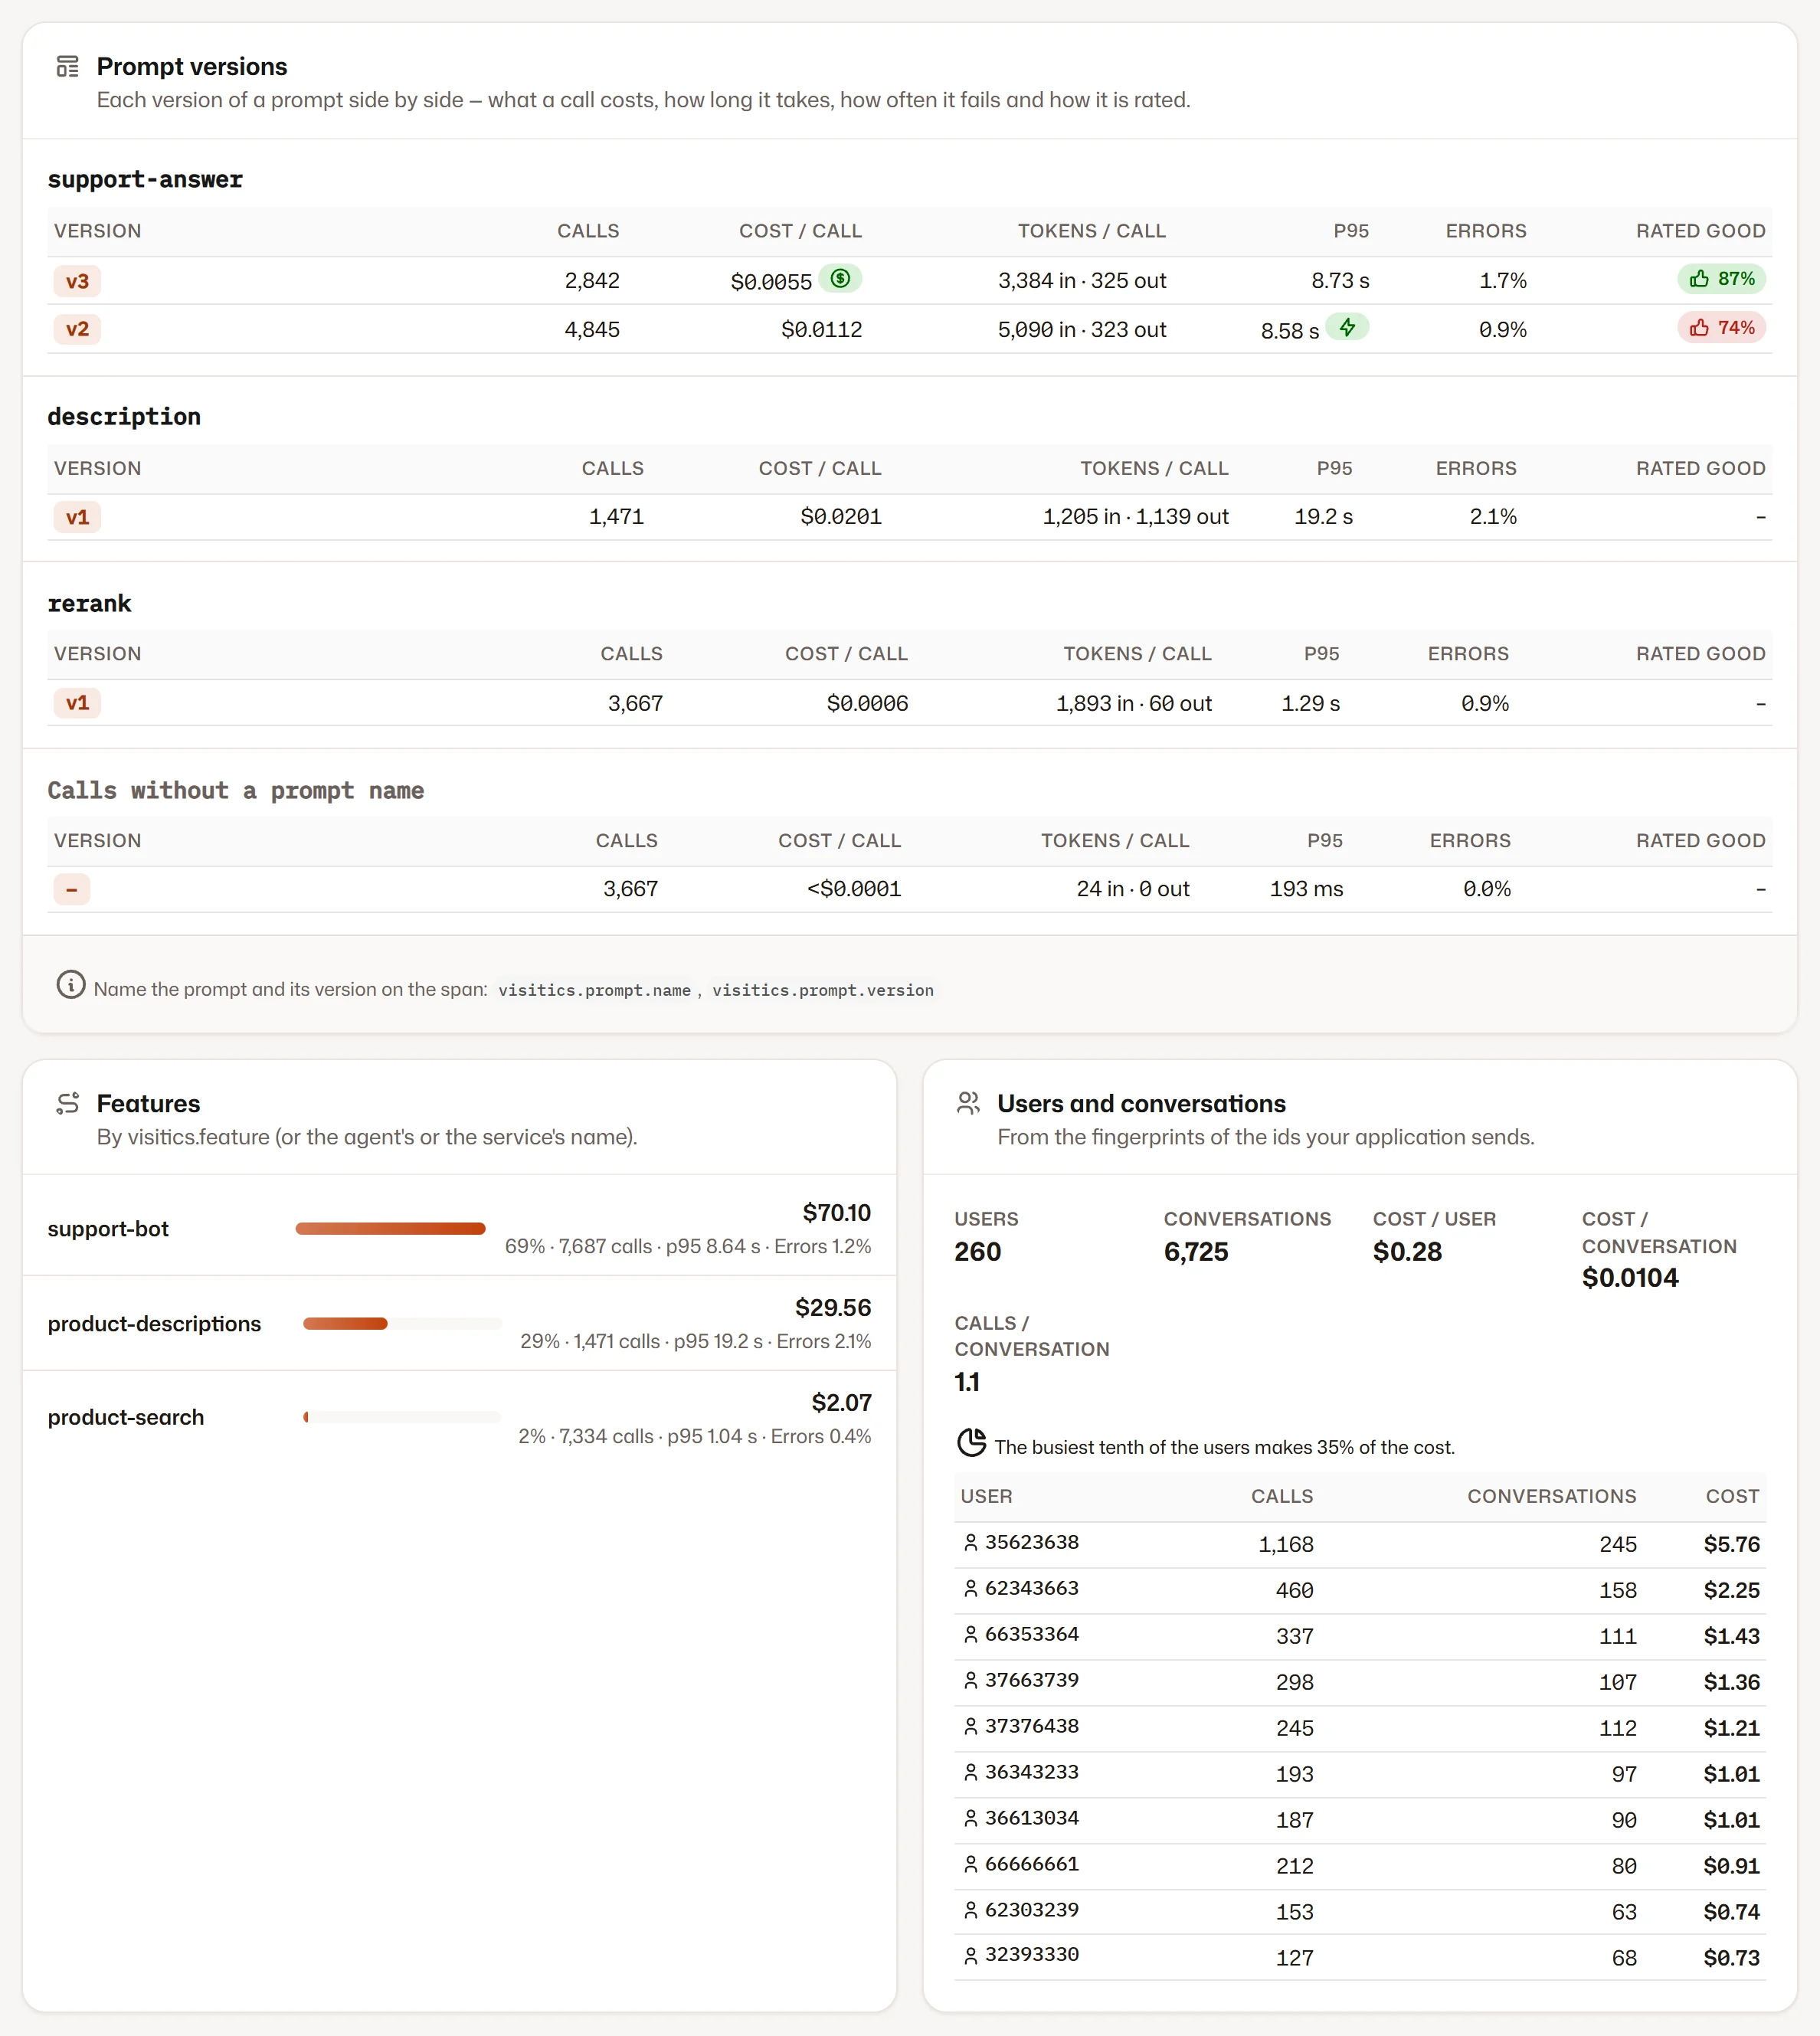
Indique el nombre del prompt y su versión al llamar al modelo, y cada versión tendrá su propia fila: el coste de una llamada, sus tokens, p95, los errores y cómo valoró la gente las respuestas. Las funciones, los usuarios y las conversaciones están en la misma pestaña.

  1. 1Versiones de prompts lado a lado
  2. 2Las funciones de su aplicación
  3. 3Usuarios y conversaciones, solo como huellas
Las versiones de un prompt
V.

Conectado en tres pasos

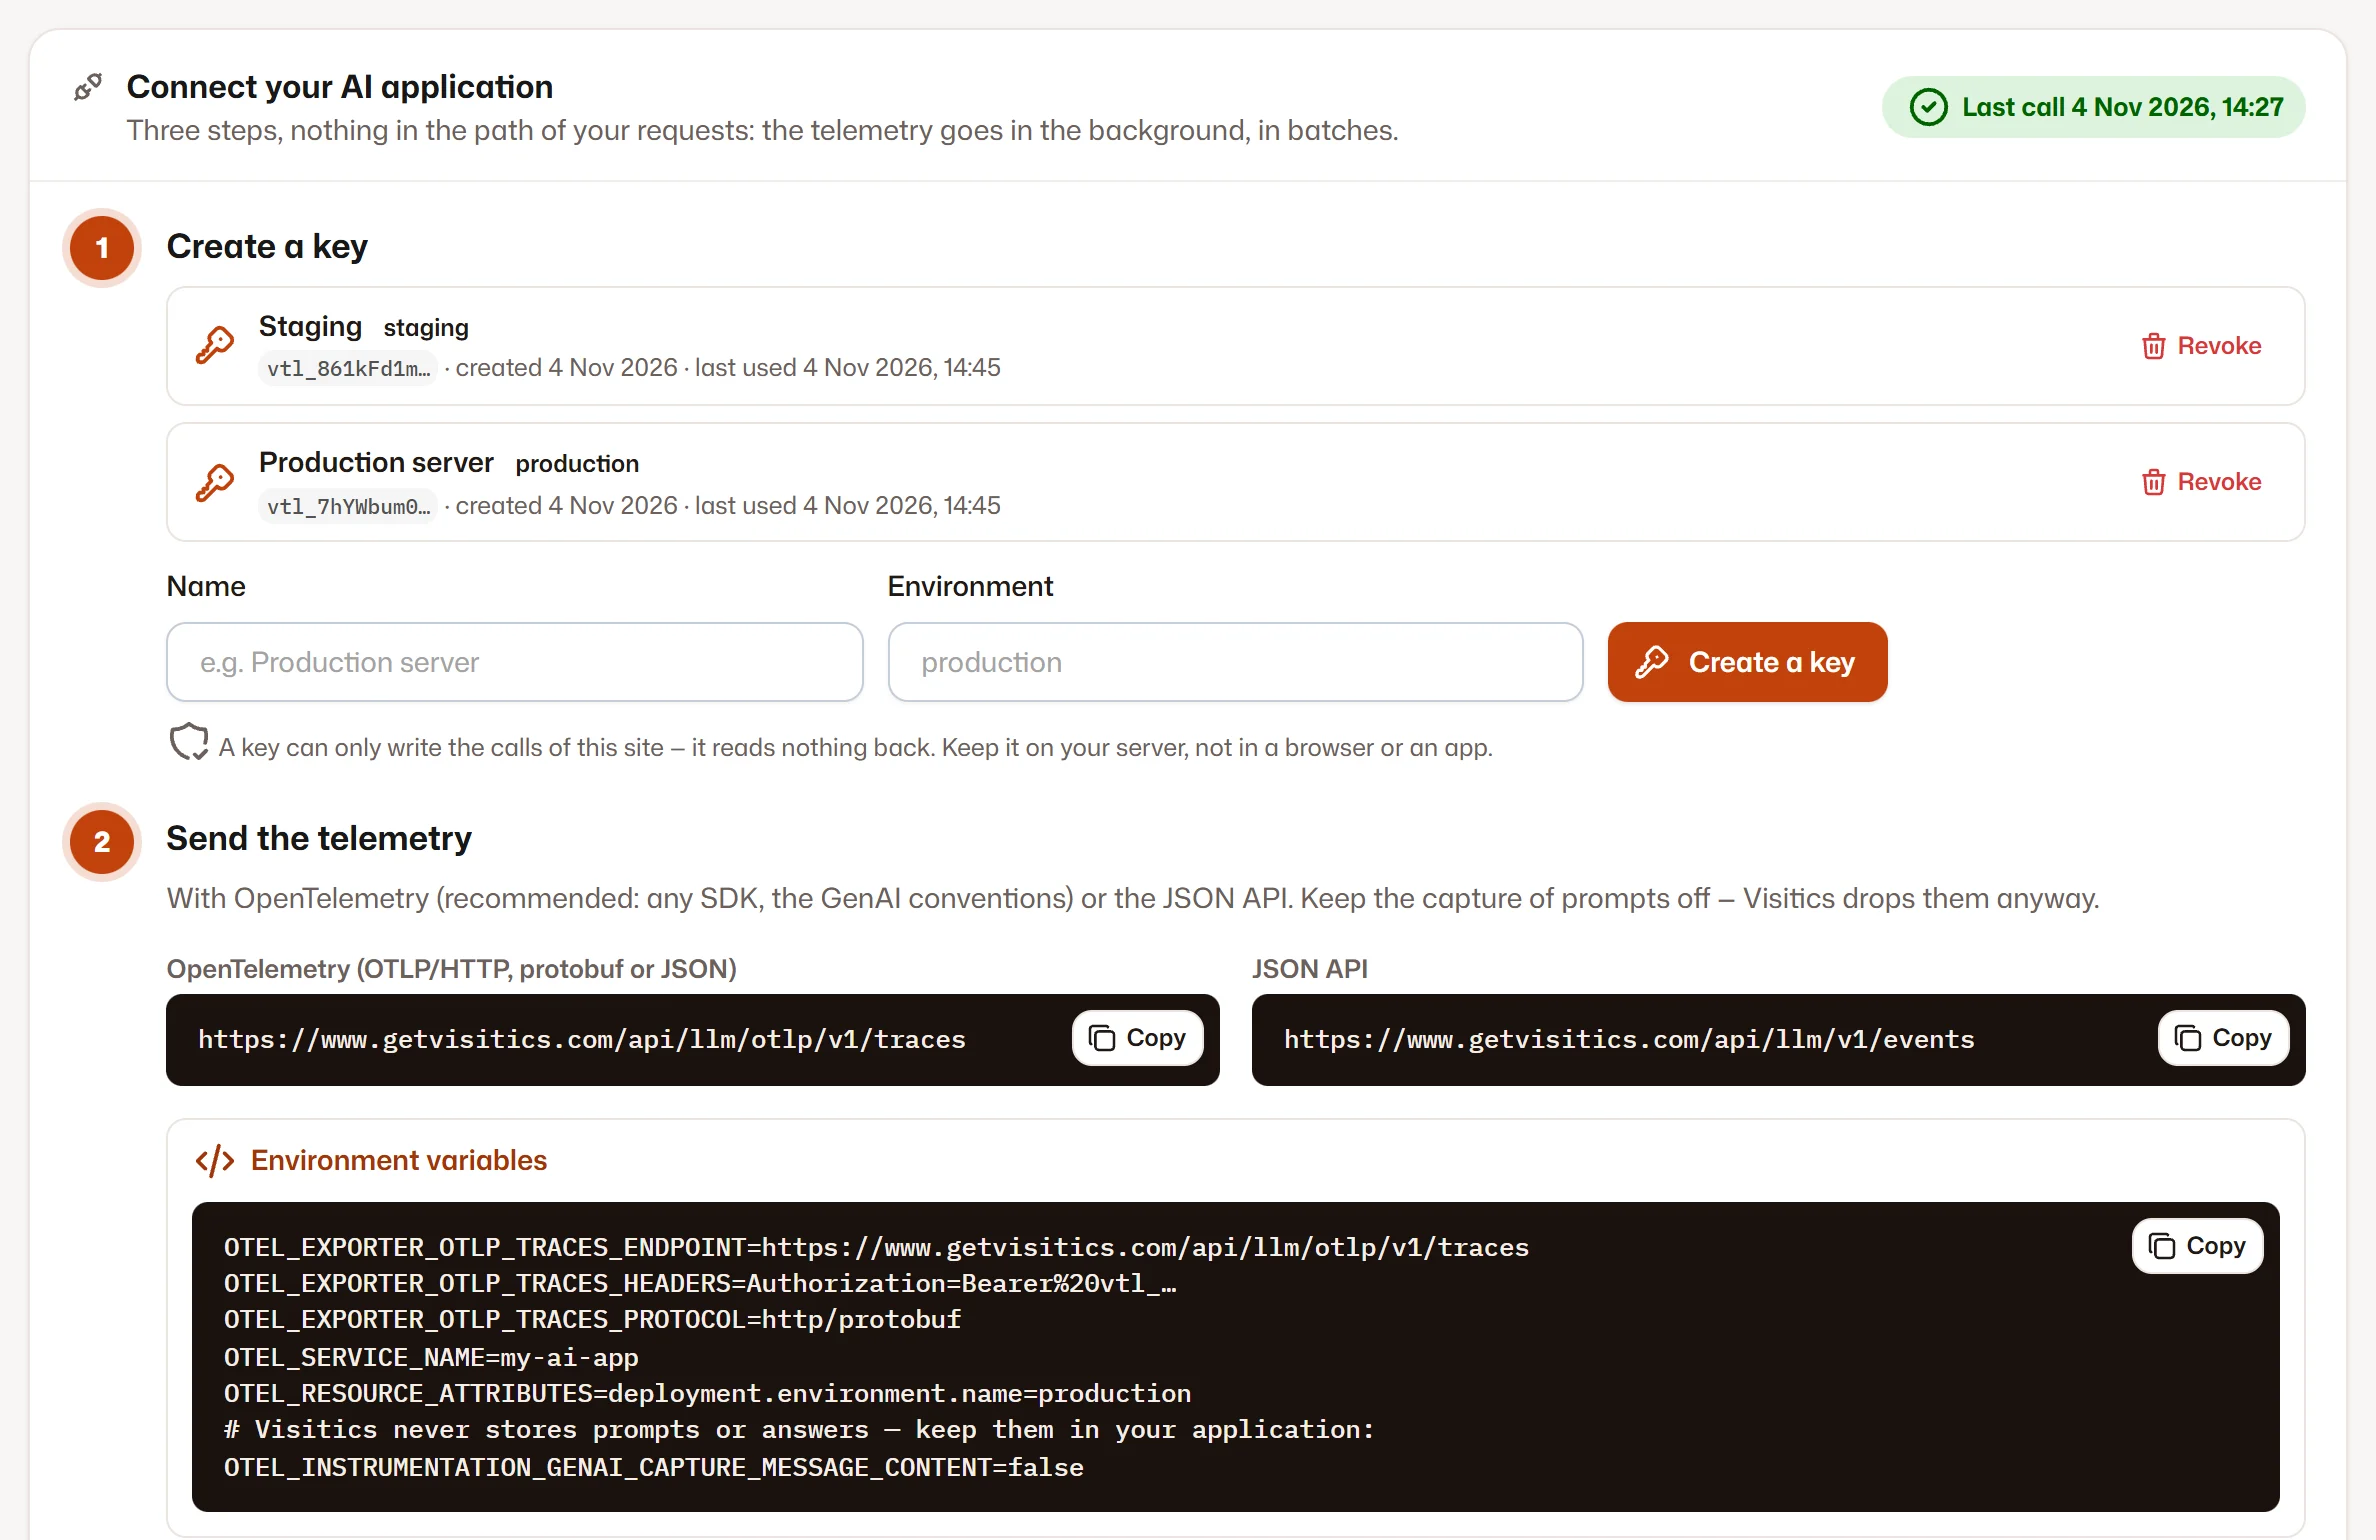
Cree una clave de solo escritura, dirija su aplicación a Visitics y haga unas cuantas llamadas: aparecen en segundos. Nada se interpone en el camino de sus peticiones, y la configuración deja desactivada la captura de prompts.

  1. 1Claves de solo escritura para cada entorno
  2. 2Las direcciones para OpenTelemetry y la API JSON
  3. 3Código listo para variables de entorno, Python, Node.js y curl
Conectado en tres pasos

Capturas del panel de Visitics con datos de demostración.

En detalle

Cómo funciona por dentro

OpenTelemetry en lugar de otro SDK

Visitics acepta las convenciones GenAI de OpenTelemetry por OTLP/HTTP, en protobuf o JSON, también comprimidas con gzip. A una aplicación ya instrumentada solo le hacen falta la dirección y una clave, y todo lo demás que exporte, como peticiones HTTP o consultas a la base de datos, se deja fuera.

Una API JSON para los casos sencillos

Una petición POST con hasta 500 llamadas: el modelo, los tokens, los tiempos y los nombres que usted elija. Los objetos usage de OpenAI, Anthropic y Gemini se leen tal como llegan, y un segundo endpoint recibe las valoraciones de las respuestas, por ejemplo un pulgar arriba o abajo.

Fuera del camino de sus peticiones

Visitics no es un proxy y no añade espera a ninguna llamada. OpenTelemetry envía en lotes y en segundo plano, Visitics responde enseguida y escribe después, y un lote enviado dos veces cuenta una sola vez.

Costes por tipo de token

La entrada, la lectura de caché, la escritura en caché y la salida tienen cada una su precio. El coste sale de una lista de precios fechada de OpenAI, Anthropic, Google y Mistral, de sus propios precios o de su aplicación. Un modelo sin precio aparece como desconocido, no como cero.

Avisos respaldados por cifras

El resumen indica qué mirar y da la cifra que hay detrás: un mes que va a superar el presupuesto, un coste que crece por más llamadas o por llamadas más caras, más errores, un modelo lento, un primer token lento, una caché de prompts que ahorraría dinero, una versión de prompt más cara.

La IA junto a sus objetivos

Cuando su servidor envía con una llamada la dirección IP y el navegador del visitante, Visitics crea la misma huella diaria que para una visita y no guarda ninguno de los dos. Así ve si los visitantes que usaron su IA alcanzan sus objetivos más a menudo que los demás: es una correlación, no una prueba. Sin esto, y sin el script de medición, todo lo demás funciona igual.

Todo lo que hace

Todo lo que incluye la función AI Observability

  • Llamadas, tokens, coste en dólares estadounidenses, latencia, primer token y errores, con el cambio respecto al periodo anterior
  • Periodos de 24 horas, 7, 30 y 90 días, filtros por entorno, proveedor, modelo y función
  • Avisos: costes al alza, más errores, un modelo lento, una caché de prompts que ahorraría dinero, una versión de prompt más cara
  • Trazas en cascada de agentes, llamadas al modelo, herramientas y recuperación de datos, con listas de las fallidas, las más lentas y las más caras
  • Modelos comparados: coste por 1000 llamadas, p50, p95, primer token, tokens por segundo, uso de la caché y errores
  • Lo que costarían los mismos tokens con otro modelo de la lista de precios
  • Versiones de prompts lado a lado, con las valoraciones de respuestas que envía su aplicación
  • Coste por función, tipo de token y día, por usuario y por conversación
  • Un presupuesto mensual con la previsión del mes y e-mails al 80 % y al 100 %
  • Claves de solo escritura para cada entorno, revocables en cualquier momento

Privacidad

Qué se guarda y qué no

Se guarda

  • Las cifras de cada llamada: tokens, tiempos, coste y si falló
  • Los nombres que envía su aplicación: modelo, función, nombre y versión del prompt, entorno
  • Huellas de los identificadores de usuarios y conversaciones, nunca los identificadores

Nunca se guarda

  • Prompts, respuestas, instrucciones ni los argumentos y resultados de las herramientas
  • El texto de los mensajes de error: un error queda solo como un código corto
  • La dirección IP o el navegador de un visitante, que solo sirven para la huella diaria si los envía

Cómo mide Visitics sin cookies

Planes

AI Observability en los planes

Los valores salen directamente de la lista de precios. Cada organización nueva prueba Aura gratis durante 14 días, sin tarjeta de pago.

AI Observability en los planes
Novagratis sin límite de tiempo Pulse9 € al mes Aura29 € al mes Luna79 € al mes
Llamadas de IA al mes con detalles 10.000 100.000 1.000.000 5.000.000
Conservación de los detalles 30 días 30 días 30 días 30 días
E-mail al 80 % y al 100 % del presupuesto No incluido en este plan Incluido Incluido Incluido
Empezar gratis Elegir Pulse Elegir Aura Elegir Luna

Ver los precios

Preguntas

Preguntas sobre la función AI Observability

¿Es lo mismo que la analítica de IA y LLM?

No. AI Observability, también llamada observabilidad de LLM, mide la IA a la que llama su propia aplicación: cuánto cuesta, qué rápida es y con qué frecuencia falla. La analítica de IA y LLM mide otra cosa: las visitas que asistentes como ChatGPT envían a su sitio web y los rastreadores de IA que lo leen.

¿Guarda Visitics mis prompts y respuestas?

No. Los prompts, las respuestas, las instrucciones y los datos de las herramientas se descartan al leer la petición, la API JSON no tiene campos para ellos y la configuración indica a su SDK que no los envíe. Ningún plan ni ajuste lo cambia.

¿Se sitúa Visitics entre mi aplicación y el modelo?

No, no es un proxy. Su aplicación llama al modelo como siempre e informa de su telemetría por separado, en lotes y en segundo plano. Si Visitics no está disponible, sus llamadas siguen como siempre; solo puede faltar su telemetría.

¿Qué modelos y SDK funcionan?

Cualquier modelo del que informe su aplicación. Visitics lee las convenciones GenAI de OpenTelemetry, de modo que instrumentaciones como OpenLLMetry y el Vercel AI SDK pueden enviarle datos directamente, y la configuración trae código listo para variables de entorno, Python, Node.js y la API JSON. La lista de precios cubre OpenAI, Anthropic, Google y Mistral; a cualquier otro modelo, por ejemplo uno en su propio servidor, le da su propio precio.

¿Hasta qué punto son exactos los costes?

Son una estimación a partir de los tokens de cada tipo y los precios de lista de los proveedores. Cada precio tiene su fecha, así que un cambio posterior no reescribe los días pasados. Si tiene un precio negociado, indique el suyo o haga que su aplicación envíe el coste con la llamada. La última palabra la tiene la factura del proveedor.

¿Qué ocurre cuando llego al límite de mi plan?

No se detiene nada. Las llamadas por encima del límite se siguen sumando, de modo que los costes, los tokens y los recuentos quedan completos; solo sus detalles, como la cascada, no se conservan durante el resto del mes.

¿Cuánto tiempo se conservan los datos?

Los detalles de cada llamada se conservan 30 días. Los resúmenes diarios siguen el historial de su plan, y la página muestra como máximo los últimos 90 días. Todo permanece en la UE y desaparece cuando elimina el sitio.

Pruebe la función AI Observability en su sitio web

Una clave y unas líneas de configuración, y las primeras llamadas aparecen en segundos. Aura gratis 14 días, después Nova sin límite de tiempo, sin tarjeta de pago.