Aller au contenu
Visiticsby esentra
FR

Gratuit dans Nova et dans chaque plan

AI Observability : ce que coûte votre IA et comment elle tourne

Votre application appelle OpenAI, Anthropic, Google, Mistral ou votre propre modèle. Visitics montre ce que coûte chaque appel, sa rapidité et la fréquence de ses échecs, par modèle, fonction et version de prompt. Il ne conserve que des chiffres et des noms : les prompts et les réponses ne sont jamais stockés.

À quoi ça sert

Ce que cela vous apporte

  1. 01

    Des coûts que vous pouvez expliquer

    Au lieu d’une somme sur la facture du fournisseur, vous voyez le coût par modèle, fonction, version de prompt et utilisateur, avec un budget mensuel et une prévision du mois.

  2. 02

    Vitesse et erreurs au même endroit

    La latence p50 et p95, le temps jusqu’au premier token et les erreurs de chaque modèle, et chaque requête sous forme de cascade de ses étapes.

  3. 03

    Des chiffres, jamais de contenu

    Les prompts et les réponses sont écartés avant toute écriture, et aucun réglage ne change cela. Visitics ne détient aucune conversation de vos utilisateurs.

Fonctionnement

De vrais écrans du tableau de bord

I.

La vue d’ensemble de votre IA

Six chiffres avec leur évolution par rapport à la période précédente, ce qu’il faut regarder d’abord et le coût de chaque jour par modèle. Filtrez toute la page par environnement, fournisseur, modèle ou fonction.

  1. 1Appels, coût, tokens, latence, premier token et erreurs
  2. 2Ce qu’il faut regarder, avec le chiffre derrière
  3. 3Le coût par modèle, jour après jour
  4. 4Le mois en cours, sa prévision et votre budget
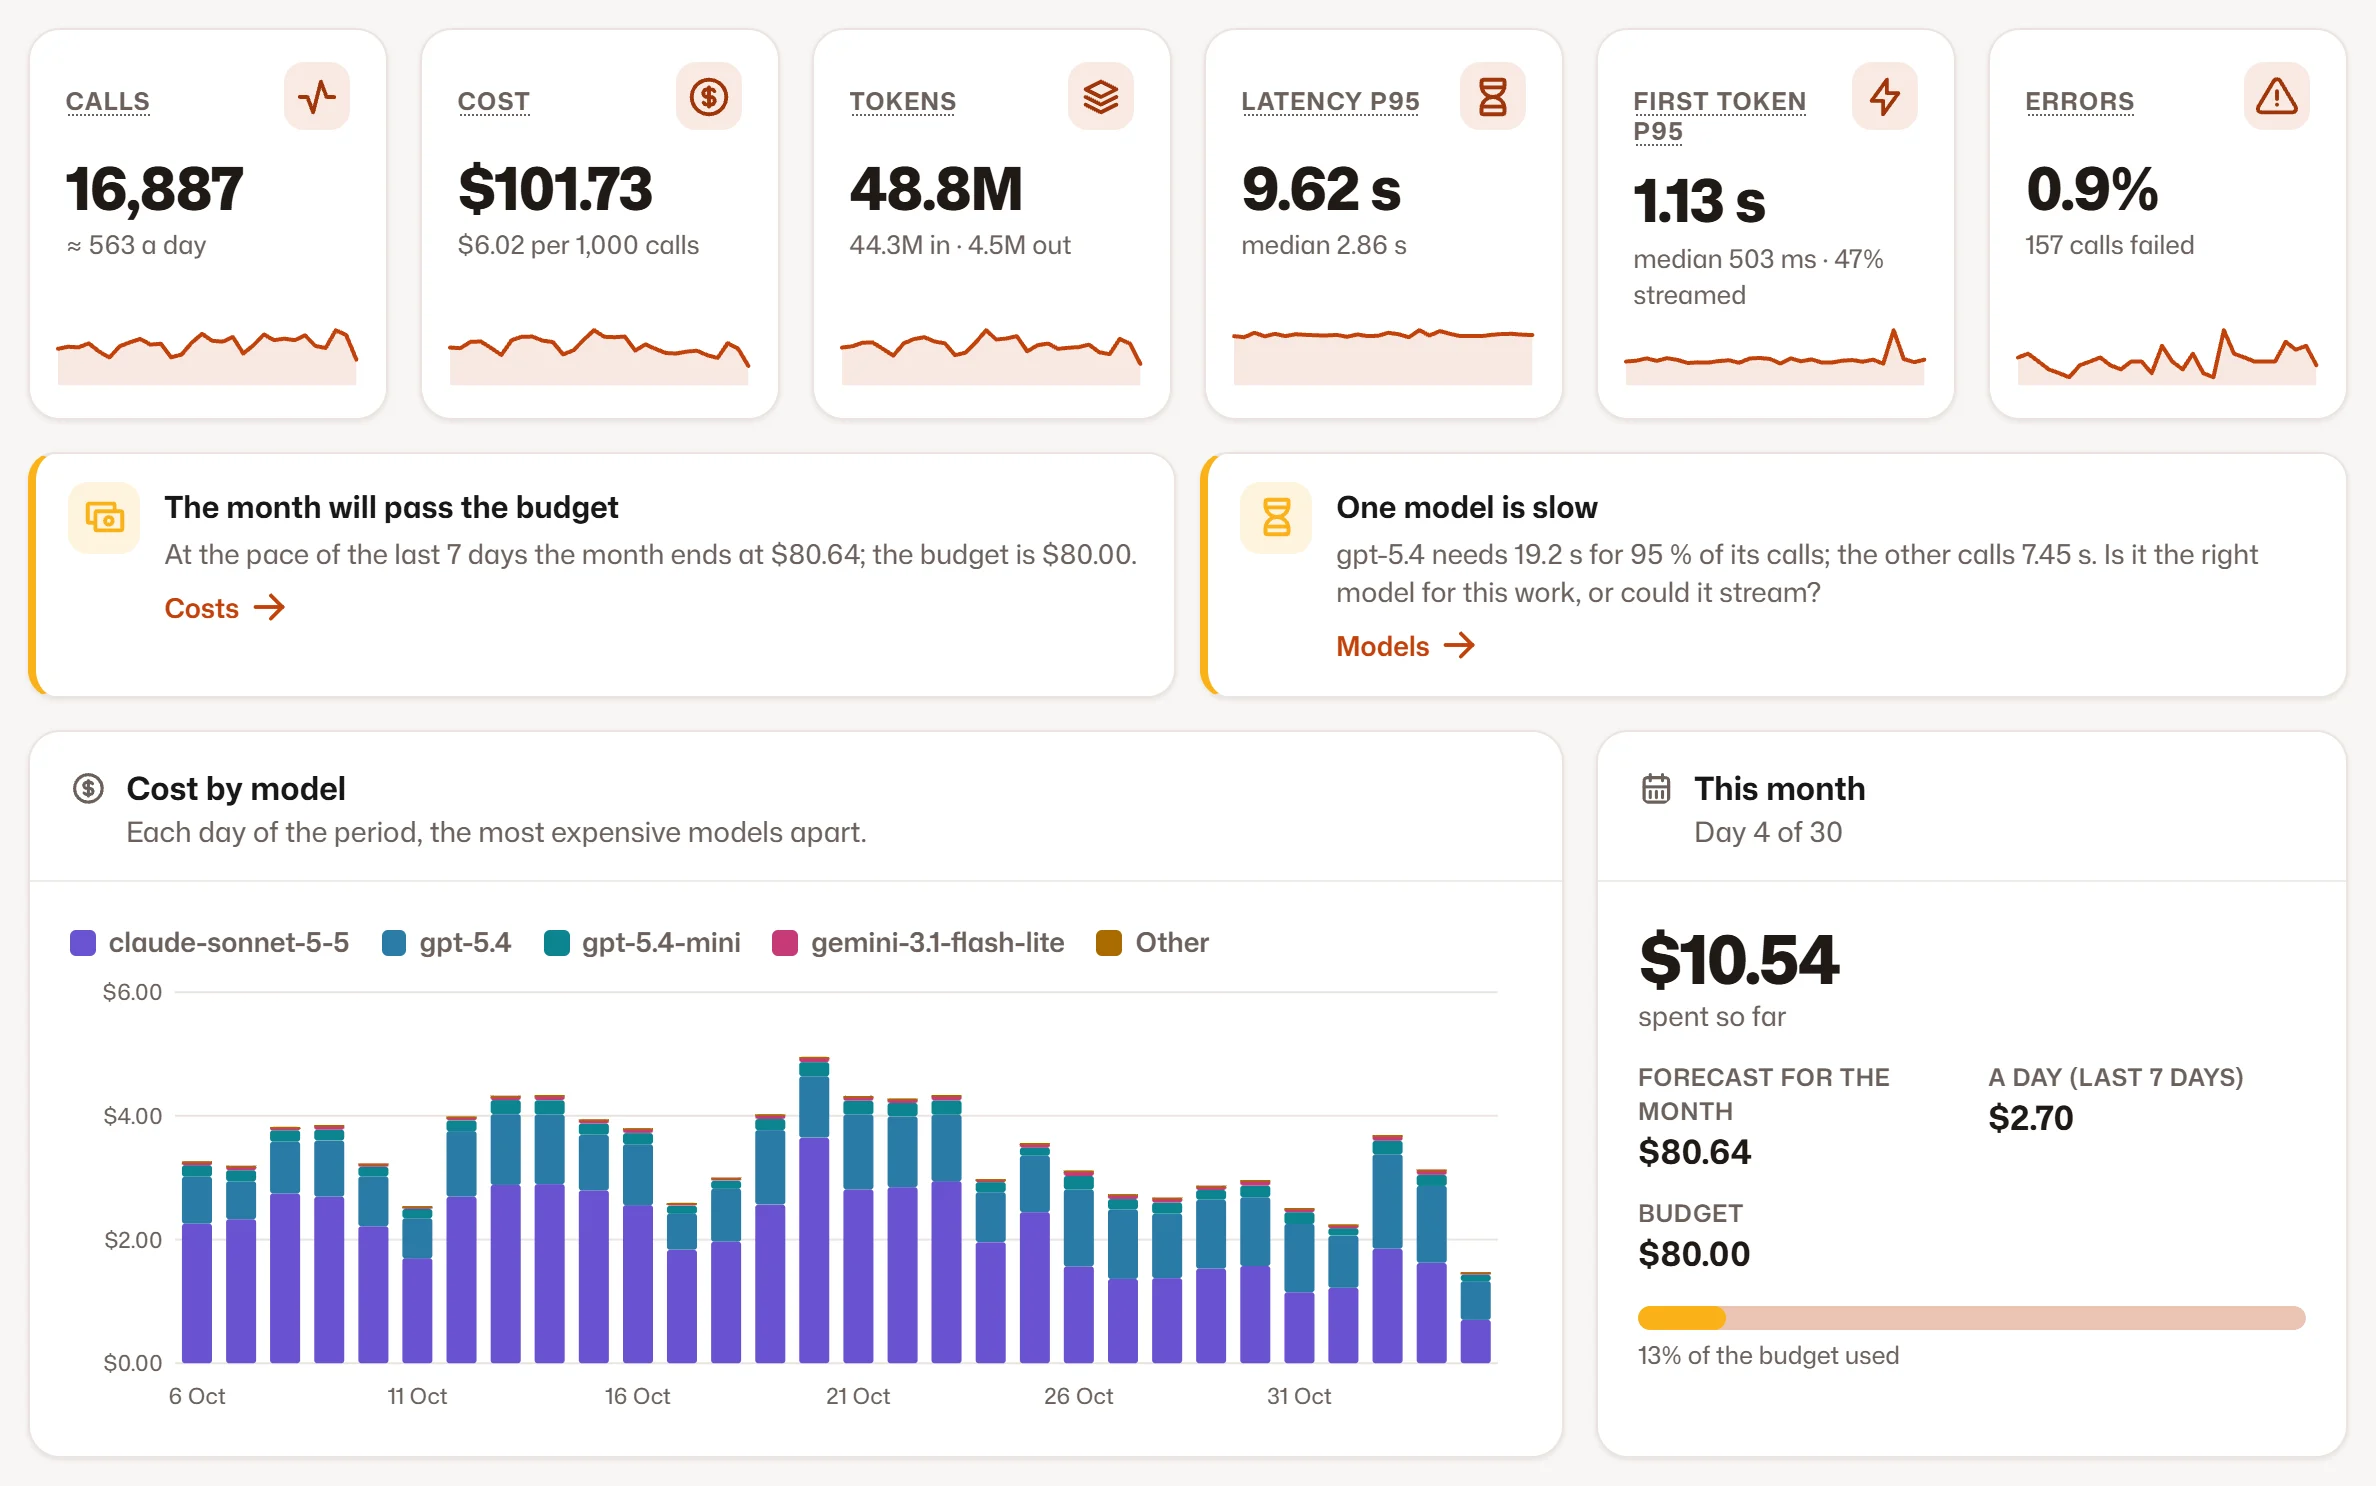
La vue d’ensemble de votre IA
II.

Une requête, étape par étape

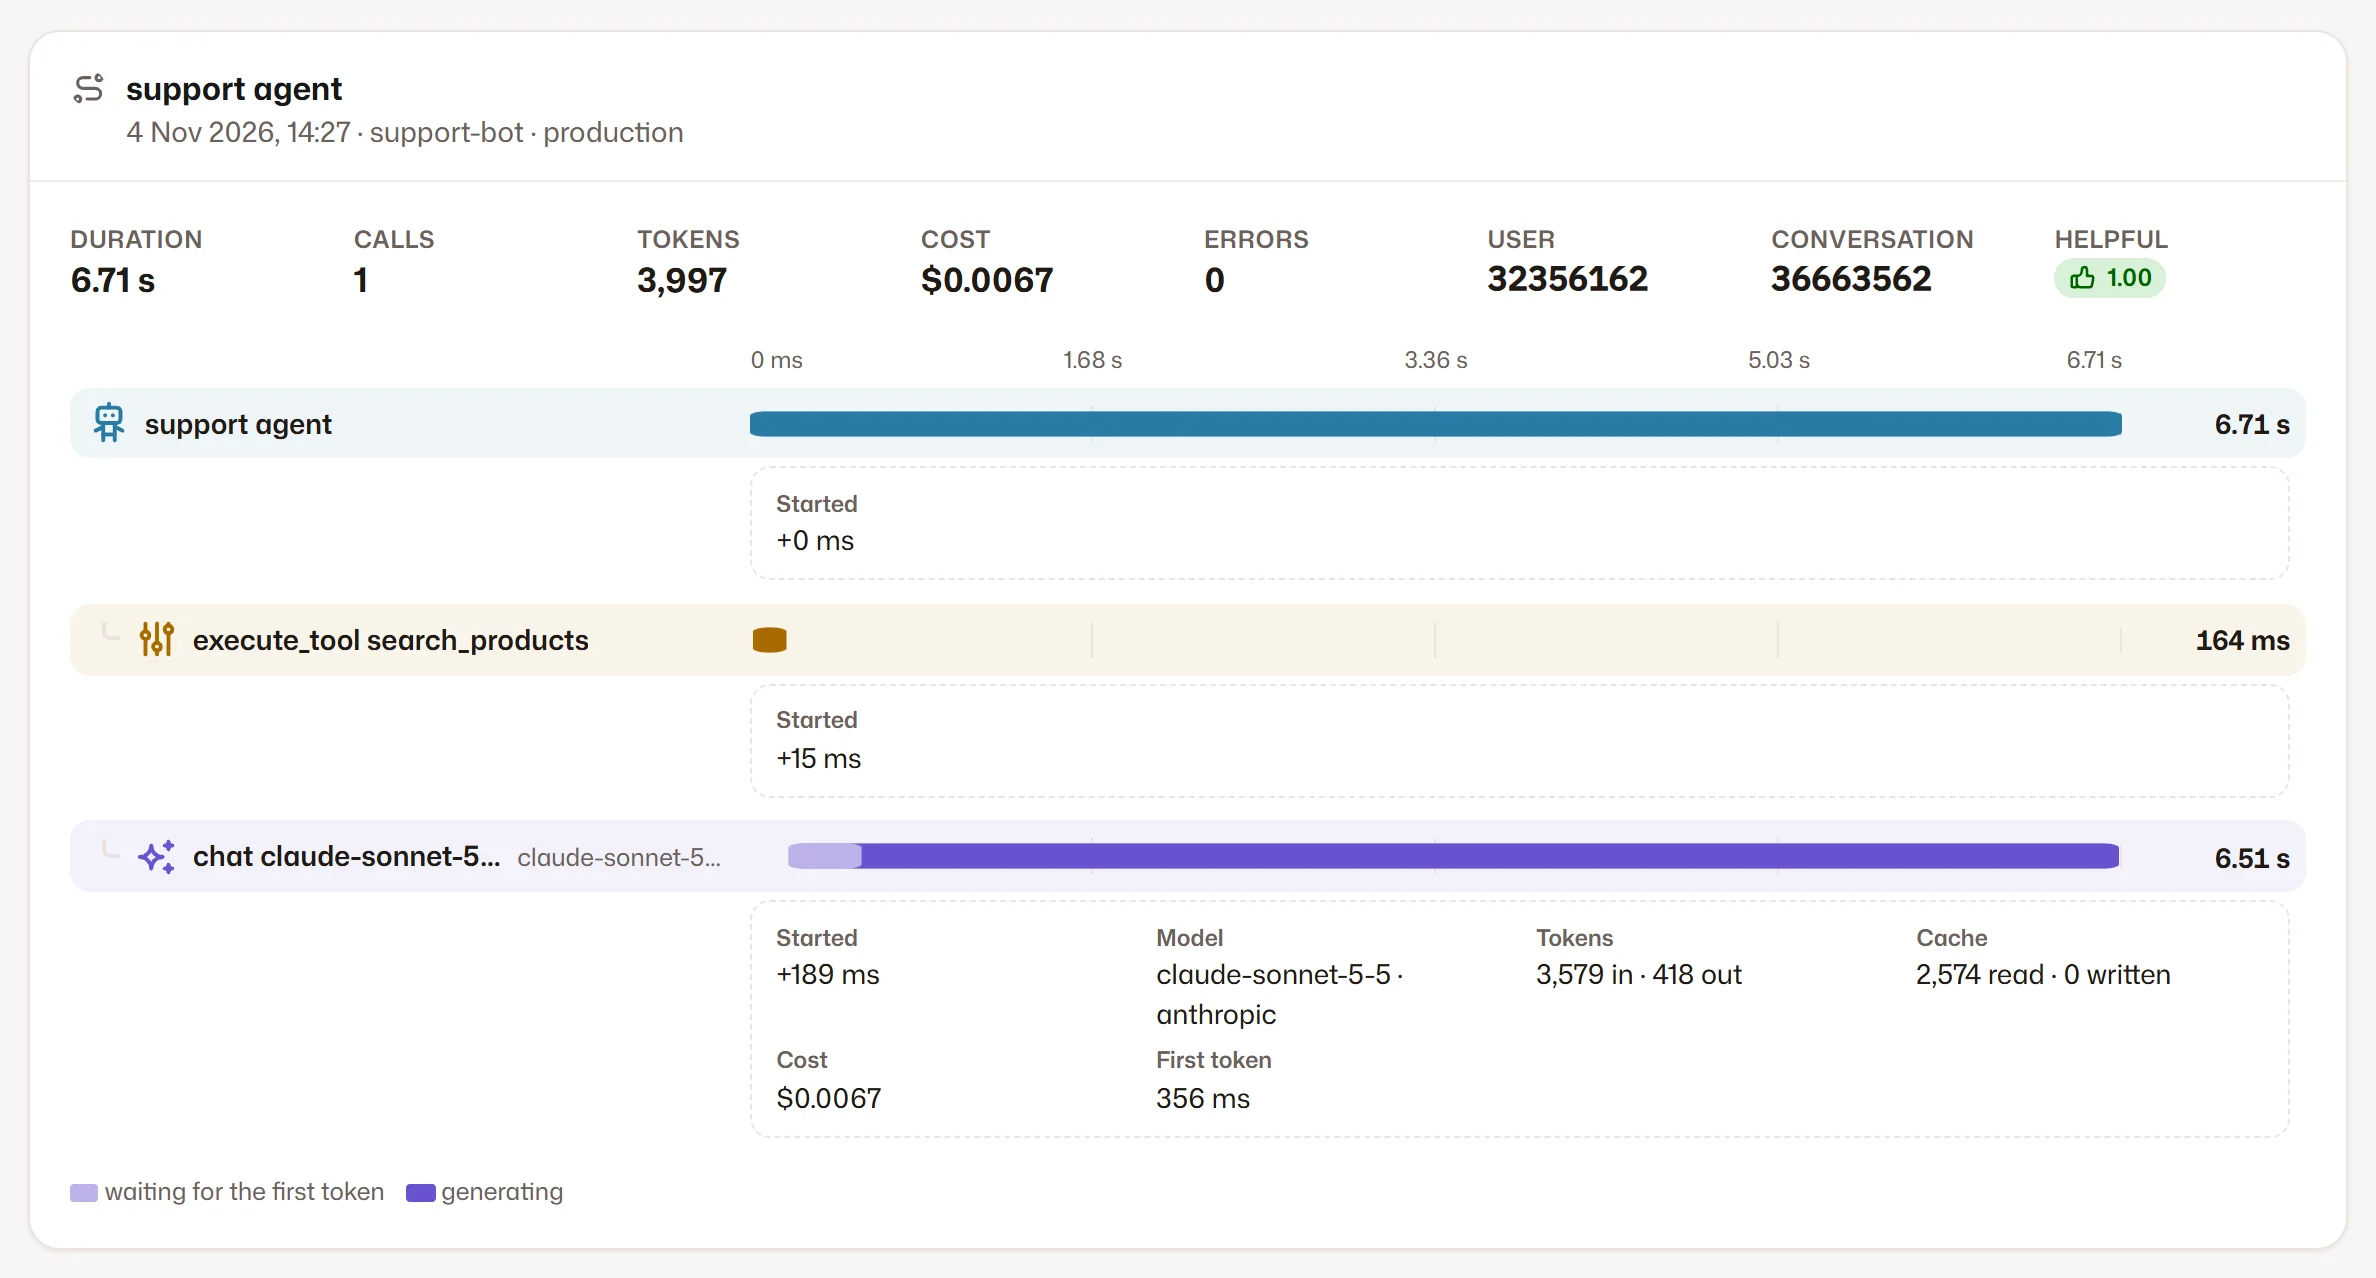
Chaque requête de votre application est une trace. Sa cascade montre dans le temps l’agent, les outils, la recherche de données et les appels au modèle, avec les tokens, le coût, le premier token et le code d’erreur de chaque appel. Les prompts et les réponses n’y figurent pas, car ils n’ont jamais été stockés.

  1. 1Les totaux de la trace et sa note
  2. 2Les étapes dans le temps
Une requête, étape par étape
III.

Les modèles côte à côte

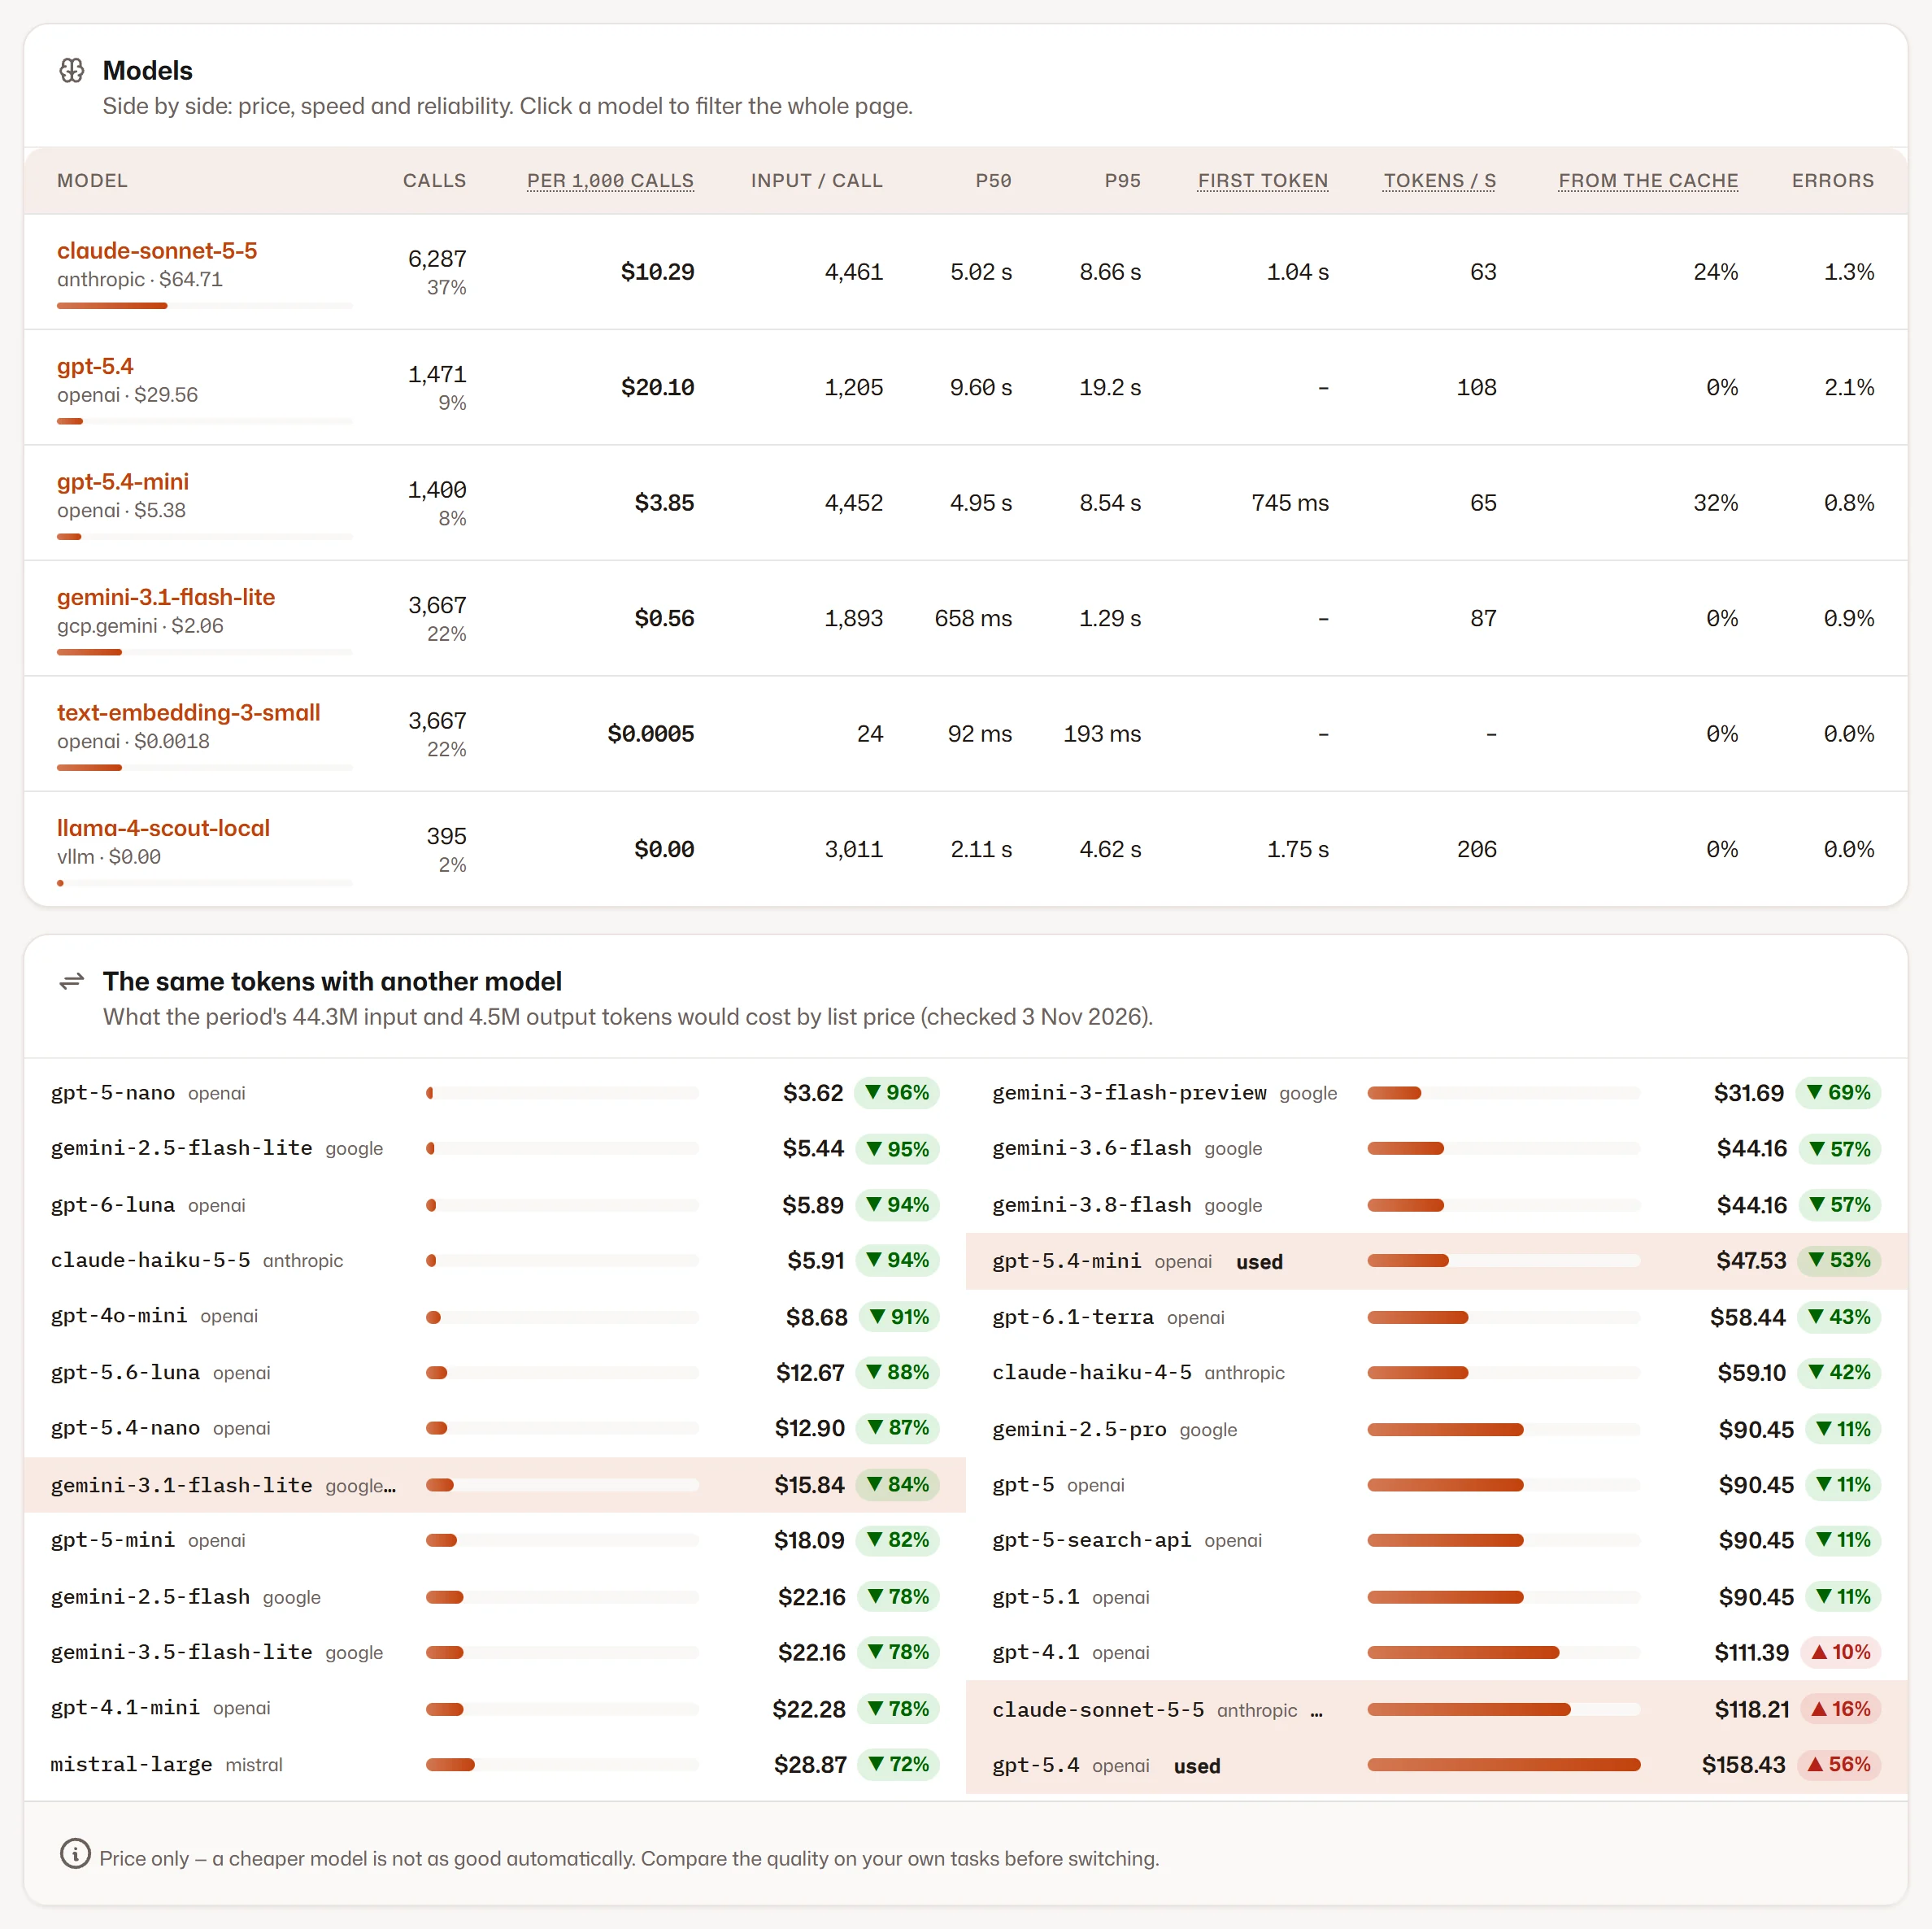
Le prix pour 1 000 appels, p50 et p95, le premier token, les tokens par seconde, l’usage du cache et les erreurs, le tout sur votre propre trafic. En dessous, ce que coûteraient les mêmes tokens avec un autre modèle de la grille tarifaire.

  1. 1Vos modèles comparés
  2. 2Les mêmes tokens avec un autre modèle
Les modèles côte à côte
IV.

Les versions d’un prompt

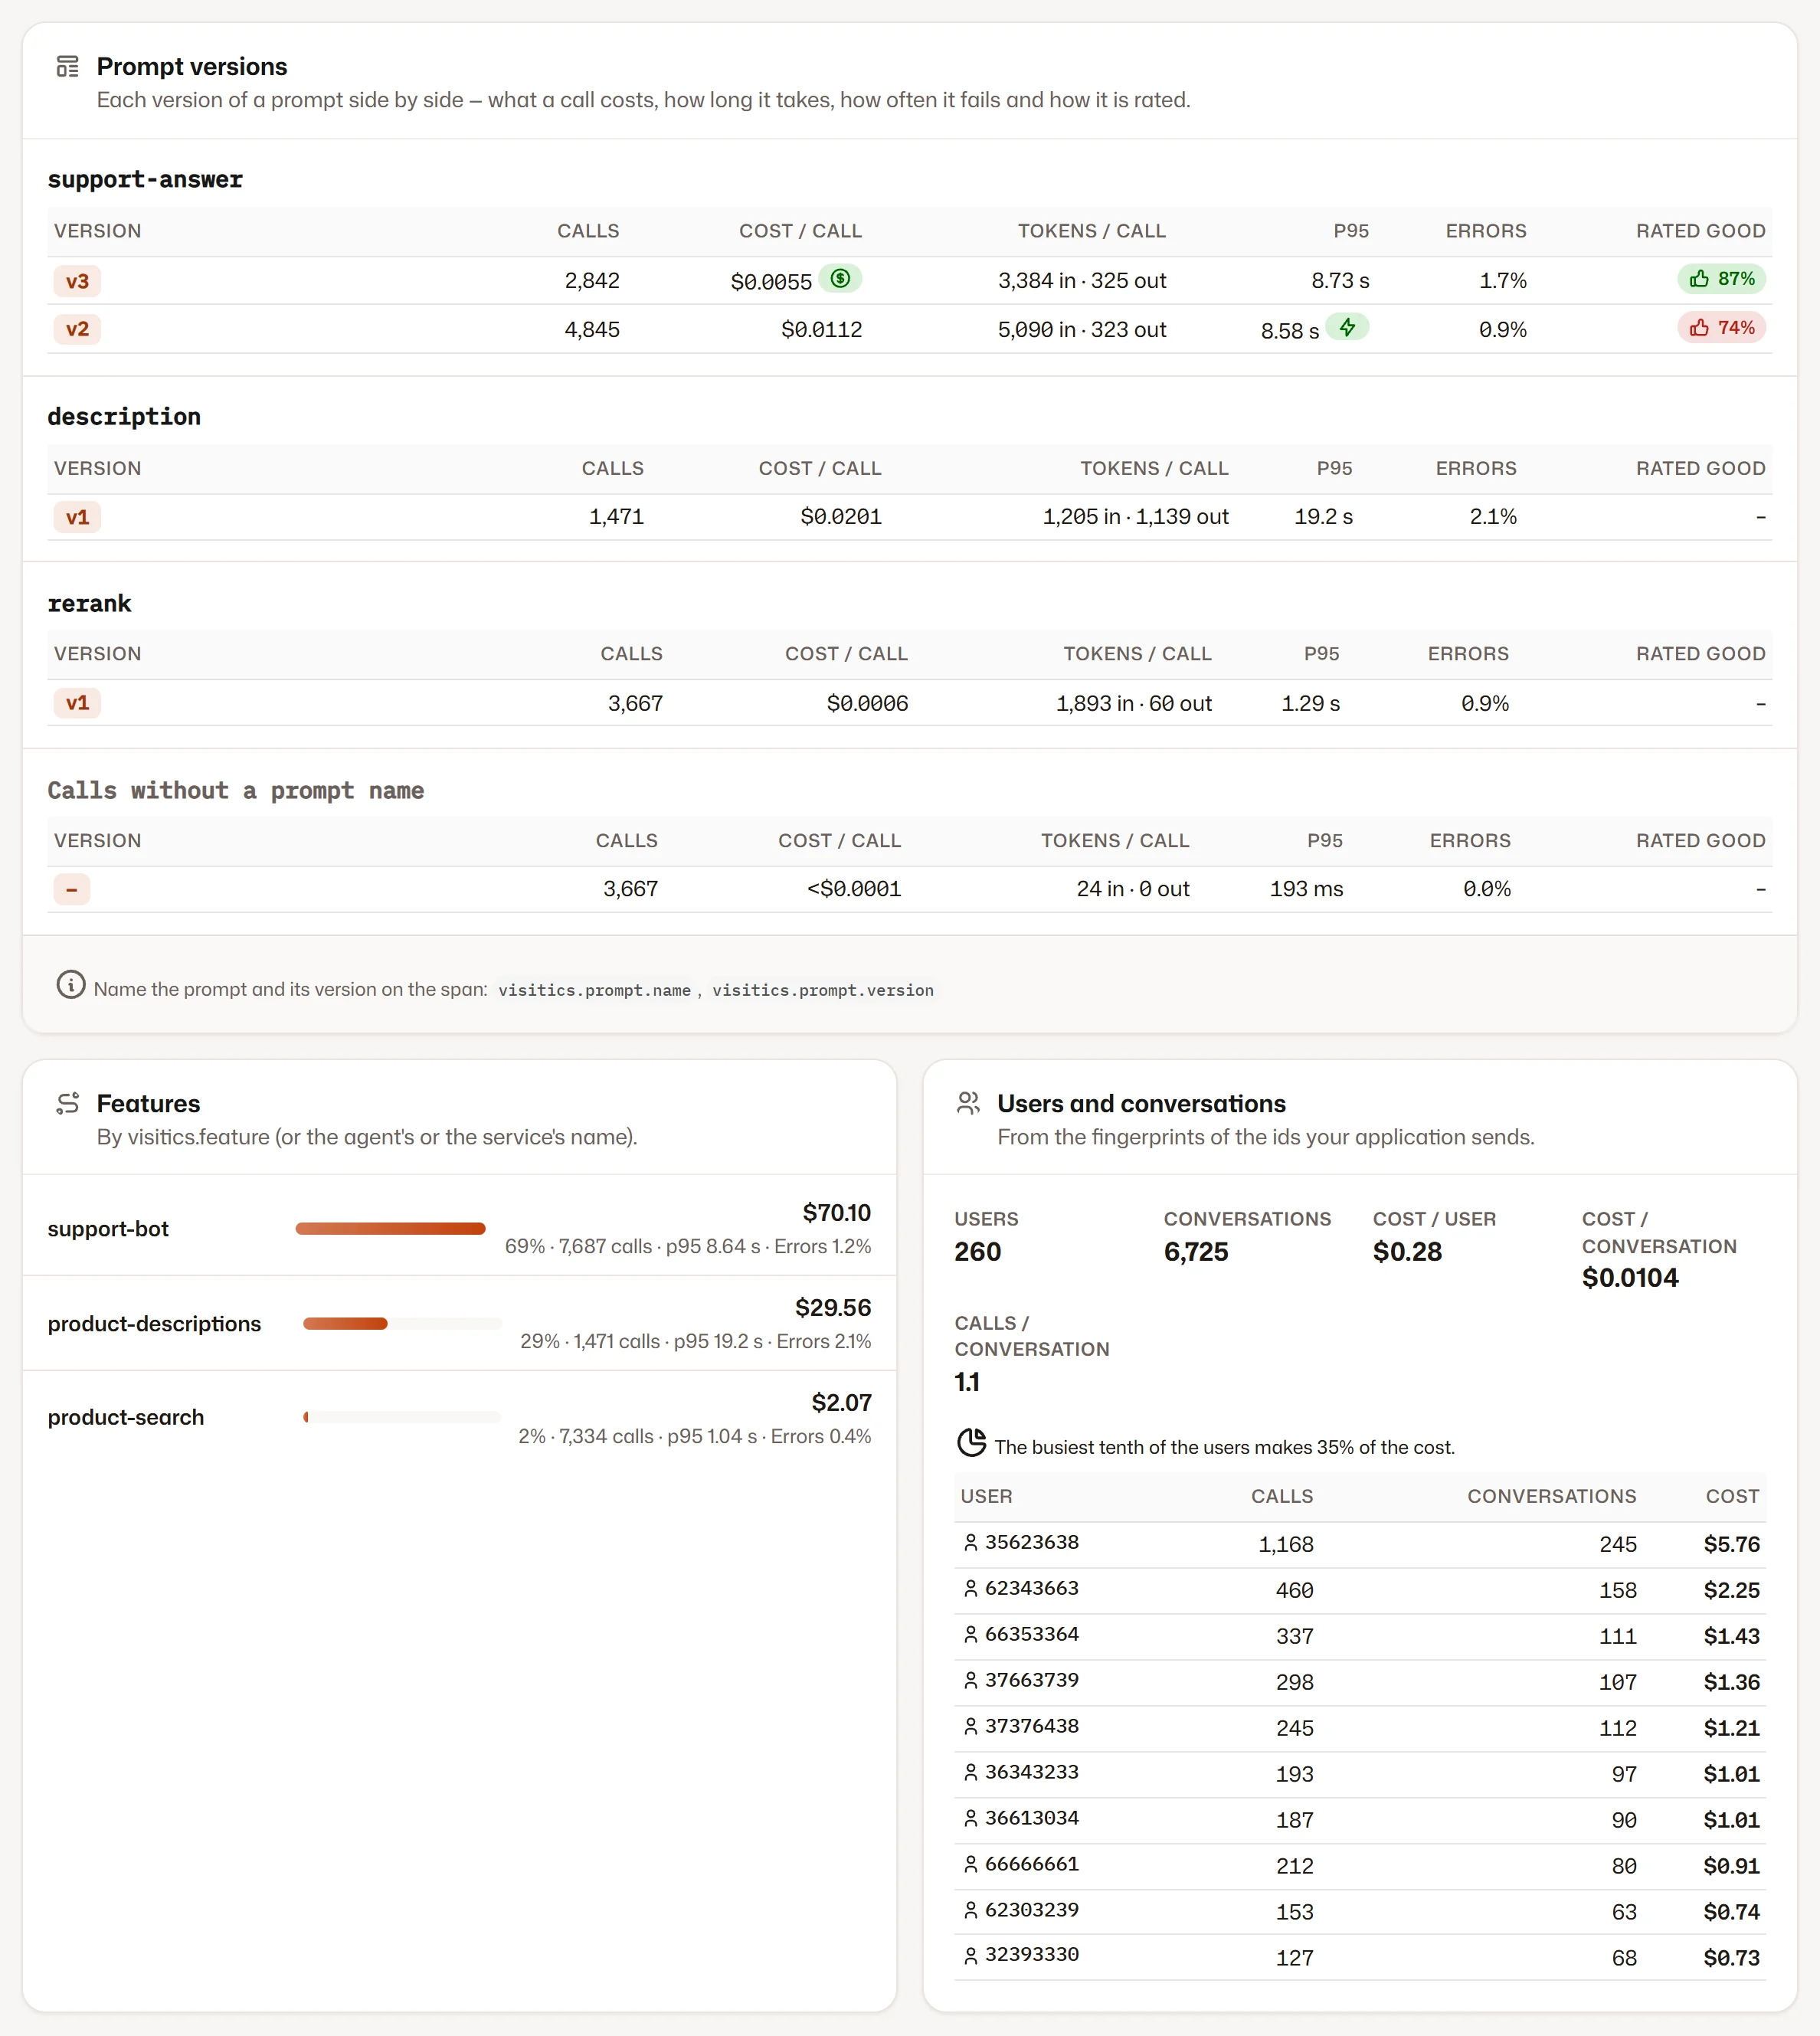
Nommez un prompt et sa version lors de l’appel au modèle, et chaque version a sa propre ligne : le coût d’un appel, ses tokens, p95, les erreurs et la note donnée aux réponses. Les fonctions, les utilisateurs et les conversations sont dans le même onglet.

  1. 1Les versions de prompts côte à côte
  2. 2Les fonctions de votre application
  3. 3Utilisateurs et conversations, sous forme d’empreintes
Les versions d’un prompt
V.

Connecté en trois étapes

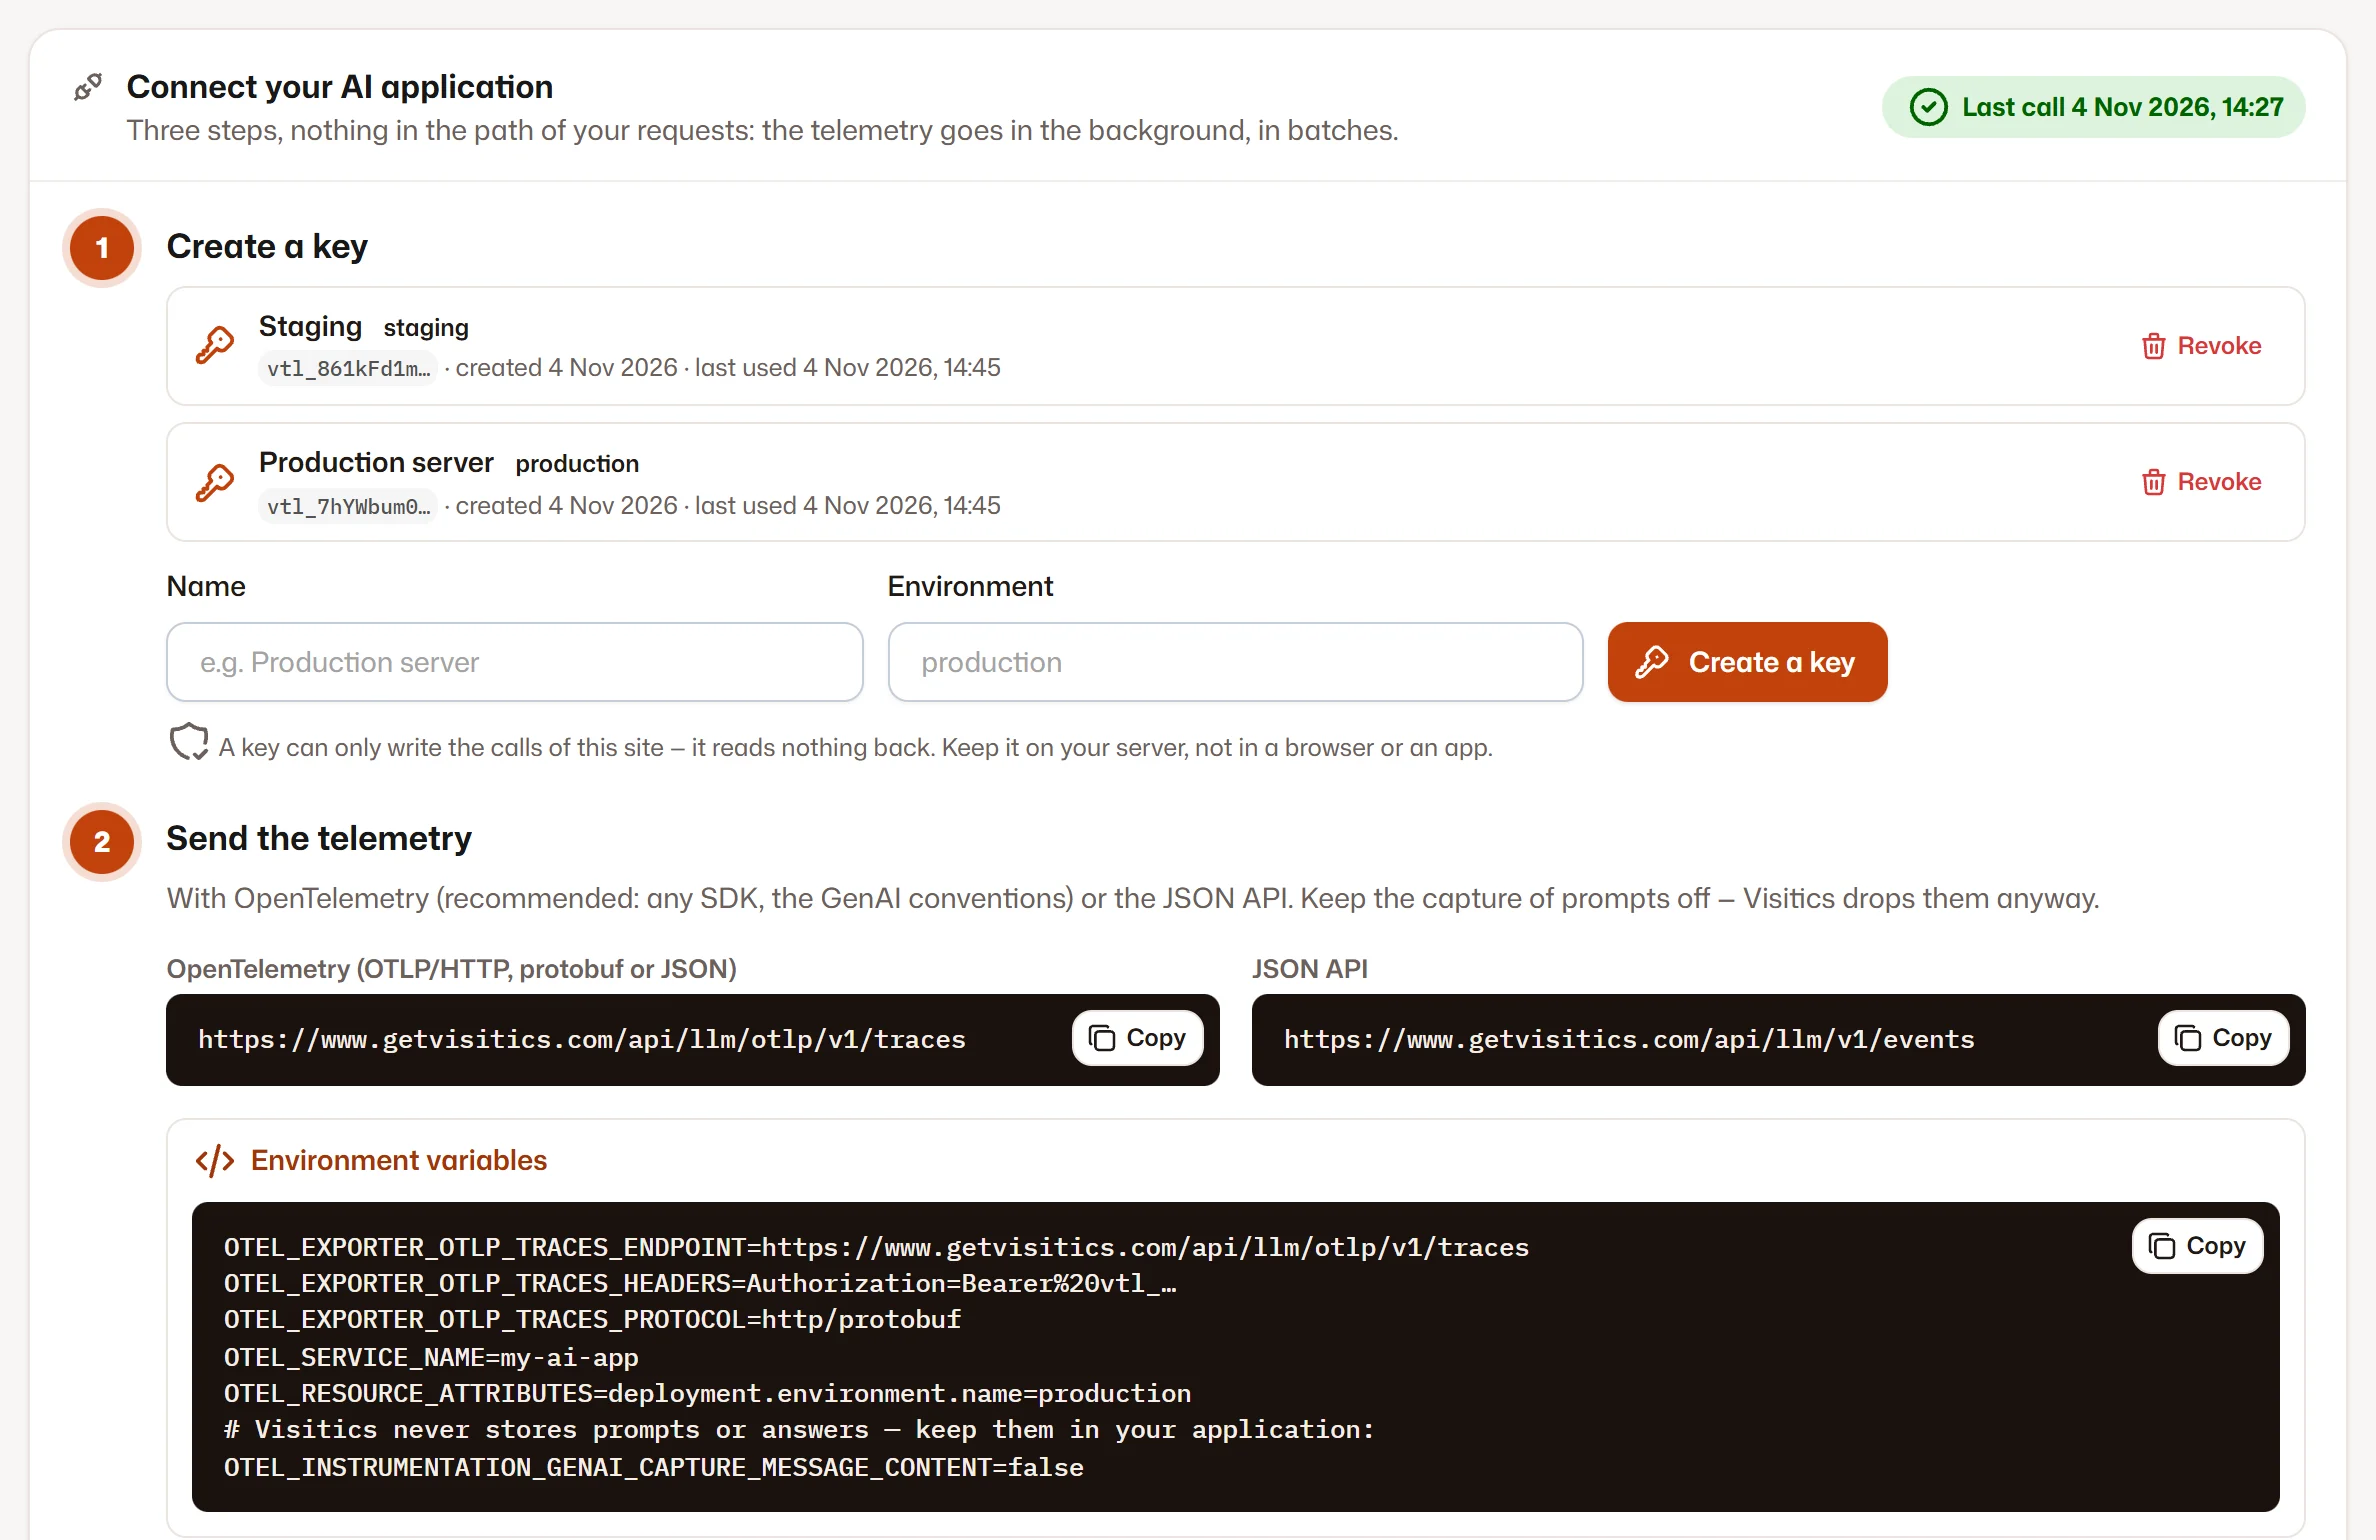
Créez une clé en écriture seule, dirigez votre application vers Visitics et faites quelques appels : ils apparaissent en quelques secondes. Rien ne se place sur le chemin de vos requêtes, et la configuration laisse la capture des prompts désactivée.

  1. 1Clés en écriture seule pour chaque environnement
  2. 2Les adresses pour OpenTelemetry et l’API JSON
  3. 3Du code prêt pour les variables d’environnement, Python, Node.js et curl
Connecté en trois étapes

Captures du tableau de bord Visitics avec des données de démonstration.

En détail

Comment cela fonctionne en coulisses

OpenTelemetry plutôt qu’un nouveau SDK

Visitics accepte les conventions GenAI d’OpenTelemetry via OTLP/HTTP, en protobuf ou JSON, compressées en gzip si besoin. Une application déjà instrumentée n’a besoin que de l’adresse et d’une clé, et tout ce qu’elle exporte d’autre, comme les requêtes HTTP ou de base de données, est laissé de côté.

Une API JSON pour les cas simples

Une requête POST avec jusqu’à 500 appels : le modèle, les tokens, les temps et les noms de votre choix. Les objets usage d’OpenAI, d’Anthropic et de Gemini sont lus tels quels, et un second point d’accès reçoit les notes des réponses, par exemple un pouce levé ou baissé.

En dehors du chemin de vos requêtes

Visitics n’est pas un proxy et n’ajoute aucune attente à un appel. OpenTelemetry envoie par lots en arrière-plan, Visitics répond aussitôt et écrit ensuite, et un lot envoyé deux fois compte une seule fois.

Les coûts par type de token

L’entrée, la lecture du cache, l’écriture dans le cache et la sortie ont chacune leur prix. Le coût vient d’une grille datée d’OpenAI, d’Anthropic, de Google et de Mistral, de vos propres prix ou de votre application. Un modèle sans prix apparaît comme inconnu, pas comme zéro.

Des alertes appuyées sur des chiffres

La vue d’ensemble dit ce qu’il faut regarder et donne le chiffre derrière : un mois parti pour dépasser le budget, un coût qui monte par plus d’appels ou des appels plus chers, davantage d’erreurs, un modèle lent, un premier token lent, un cache de prompts qui ferait économiser, une version de prompt plus chère.

L’IA à côté de vos objectifs

Quand votre serveur envoie avec un appel l’adresse IP et le navigateur du visiteur, Visitics en tire la même empreinte quotidienne que pour une visite et ne stocke ni l’une ni l’autre. Vous voyez alors si les visiteurs qui ont utilisé votre IA atteignent vos objectifs plus souvent que les autres : une corrélation, pas une preuve. Sans cela, et sans le script de mesure, tout le reste fonctionne de la même façon.

Tout ce qu’il fait

Tout ce que comprend la fonction AI Observability

  • Appels, tokens, coût en dollars américains, latence, premier token et erreurs, avec l’évolution par rapport à la période précédente
  • Périodes de 24 heures, 7, 30 et 90 jours, filtres par environnement, fournisseur, modèle et fonction
  • Alertes : coûts en hausse, davantage d’erreurs, modèle lent, cache de prompts qui ferait économiser, version de prompt plus chère
  • Traces en cascade d’agents, d’appels au modèle, d’outils et de recherche de données, avec les listes des échecs, des plus lentes et des plus chères
  • Modèles comparés : coût pour 1 000 appels, p50, p95, premier token, tokens par seconde, usage du cache et erreurs
  • Ce que coûteraient les mêmes tokens avec un autre modèle de la grille tarifaire
  • Versions de prompts côte à côte, avec les notes de réponses envoyées par votre application
  • Coût par fonction, type de token et jour, par utilisateur et par conversation
  • Un budget mensuel avec la prévision du mois et des e-mails à 80 % et 100 %
  • Clés en écriture seule pour chaque environnement, révocables à tout moment

Confidentialité

Ce qui est enregistré — et ce qui ne l’est pas

Enregistré

  • Les chiffres de chaque appel : tokens, temps, coût et échec éventuel
  • Les noms envoyés par votre application : modèle, fonction, nom et version du prompt, environnement
  • Des empreintes des identifiants d’utilisateurs et de conversations, jamais les identifiants

Jamais enregistré

  • Les prompts, les réponses, les instructions, ni les arguments et résultats des outils
  • Le texte des messages d’erreur : une erreur reste un simple code court
  • L’adresse IP ou le navigateur d’un visiteur, qui servent seulement à l’empreinte quotidienne si vous les envoyez

Comment Visitics mesure sans cookies

Plans

AI Observability dans les plans

Les valeurs viennent directement de la grille tarifaire. Chaque nouvelle organisation essaie Aura gratuitement pendant 14 jours, sans carte de paiement.

AI Observability dans les plans
Novagratuit sans limite de durée Pulse9 € par mois Aura29 € par mois Luna79 € par mois
Appels IA par mois avec détails 10 000 100 000 1 000 000 5 000 000
Conservation des détails 30 jours 30 jours 30 jours 30 jours
E-mail à 80 % et 100 % du budget Pas dans ce plan Inclus Inclus Inclus
Commencer gratuitement Choisir Pulse Choisir Aura Choisir Luna

Voir les tarifs

Questions

Questions sur la fonction AI Observability

Est-ce la même chose que l’analyse IA et LLM ?

Non. AI Observability, aussi appelée observabilité LLM, mesure l’IA qu’appelle votre propre application : ce qu’elle coûte, sa rapidité et la fréquence de ses échecs. L’analyse IA et LLM mesure autre chose : les visites que des assistants comme ChatGPT envoient vers votre site et les robots IA qui le lisent.

Visitics conserve-t-il mes prompts et mes réponses ?

Non. Les prompts, les réponses, les instructions et les données des outils sont écartés dès la lecture de la requête, l’API JSON n’a aucun champ pour eux et la configuration indique à votre SDK de ne pas les envoyer. Aucun plan ni réglage n’y change rien.

Visitics se place-t-il entre mon application et le modèle ?

Non, ce n’est pas un proxy. Votre application appelle le modèle comme avant et remonte sa télémétrie à part, par lots et en arrière-plan. Si Visitics est injoignable, vos appels continuent normalement ; seule leur télémétrie peut manquer.

Quels modèles et SDK fonctionnent ?

Tout modèle que votre application signale. Visitics lit les conventions GenAI d’OpenTelemetry : des instrumentations comme OpenLLMetry et le Vercel AI SDK peuvent donc lui envoyer directement, et la configuration fournit du code prêt pour les variables d’environnement, Python, Node.js et l’API JSON. La grille tarifaire couvre OpenAI, Anthropic, Google et Mistral ; pour tout autre modèle, par exemple sur votre propre serveur, indiquez votre prix.

Quelle est la précision des coûts ?

Ils sont estimés à partir des tokens de chaque type et des prix catalogue des fournisseurs. Chaque prix a sa date : un changement ultérieur ne réécrit donc pas les jours passés. Pour un prix négocié, indiquez le vôtre ou faites envoyer le coût par votre application avec l’appel. La facture du fournisseur reste la référence.

Que se passe-t-il quand j’atteins la limite de mon plan ?

Rien ne s’arrête. Les appels au-delà de la limite restent additionnés : coûts, tokens et compteurs restent complets ; seuls leurs détails, comme la cascade, ne sont plus conservés jusqu’à la fin du mois.

Combien de temps les données sont-elles conservées ?

Les détails de chaque appel restent 30 jours. Les résumés quotidiens suivent l’historique de votre plan et la page en montre au plus les 90 derniers jours. Tout reste dans l’UE et disparaît lorsque vous supprimez le site.

Essayez la fonction AI Observability sur votre site

Une clé et quelques lignes de configuration, et les premiers appels apparaissent en quelques secondes. Aura gratuit 14 jours, puis Nova sans limite de durée — sans carte de paiement.